SaaS próprio · IA em tempo real
ScribeDash
Uma aplicação web de reconhecimento de voz em tempo real que transforma áudio ao vivo em transcrições precisas e identificadas por orador enquanto fala. Ligue um microfone, comece a gravar e veja as palavras a surgir instantaneamente, com tecnologia de IA a correr na minha própria GPU inference.
Um olhar por dentro do ScribeDash
Da página inicial ao estúdio de gravação ao vivo.
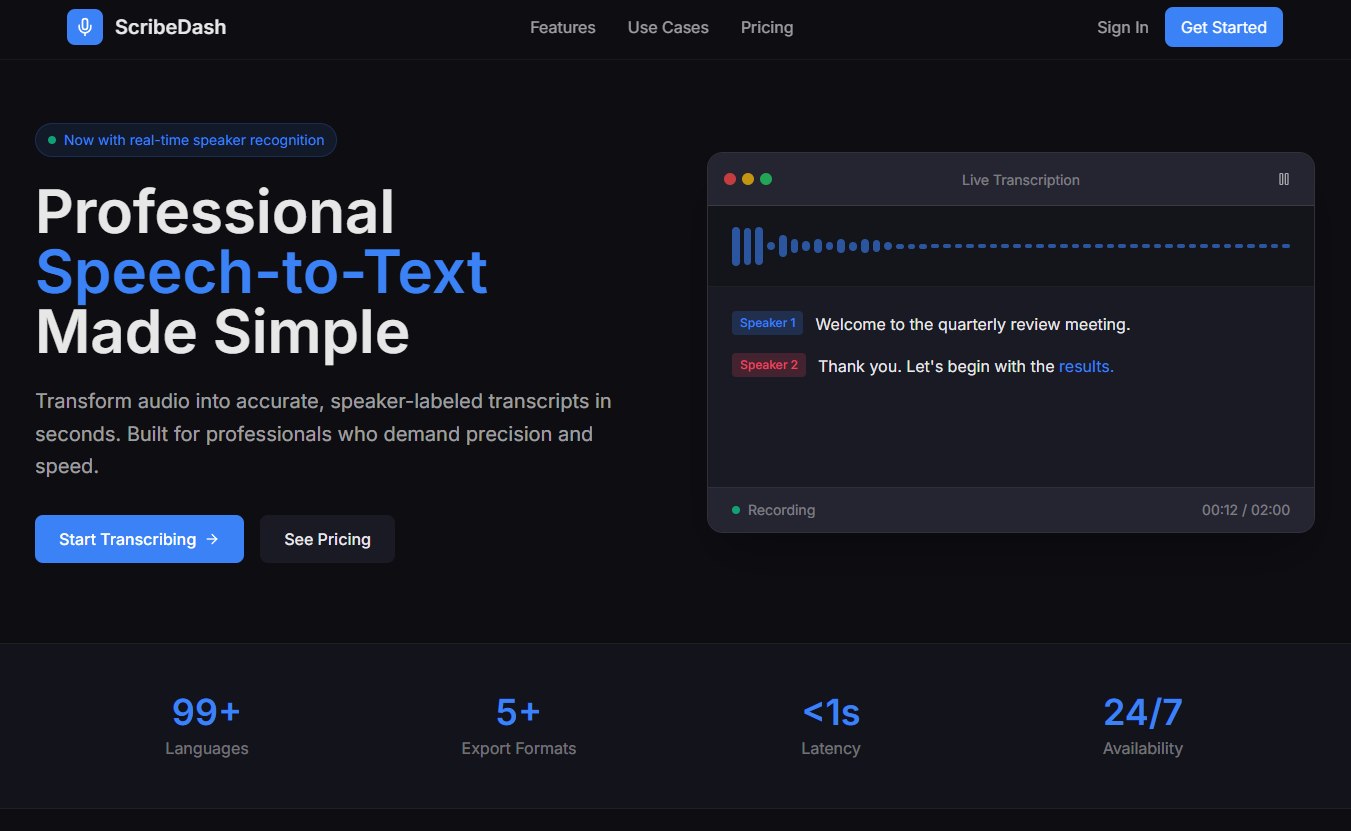
Reconhecimento de voz profissional
A página inicial: transforme áudio em transcrições precisas e identificadas por orador em segundos.
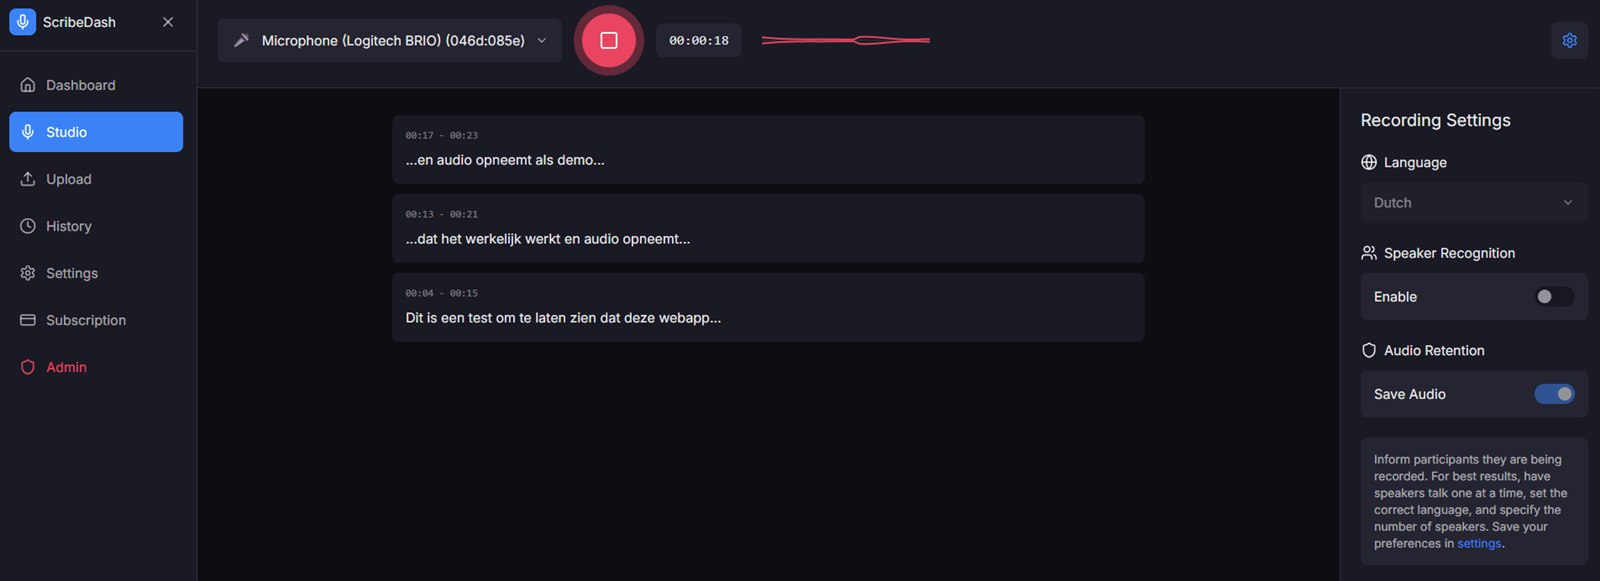
Estúdio de gravação ao vivo
Grave a partir de qualquer microfone e veja a transcrição a fluir em tempo real, com definições de idioma e de reconhecimento de orador.
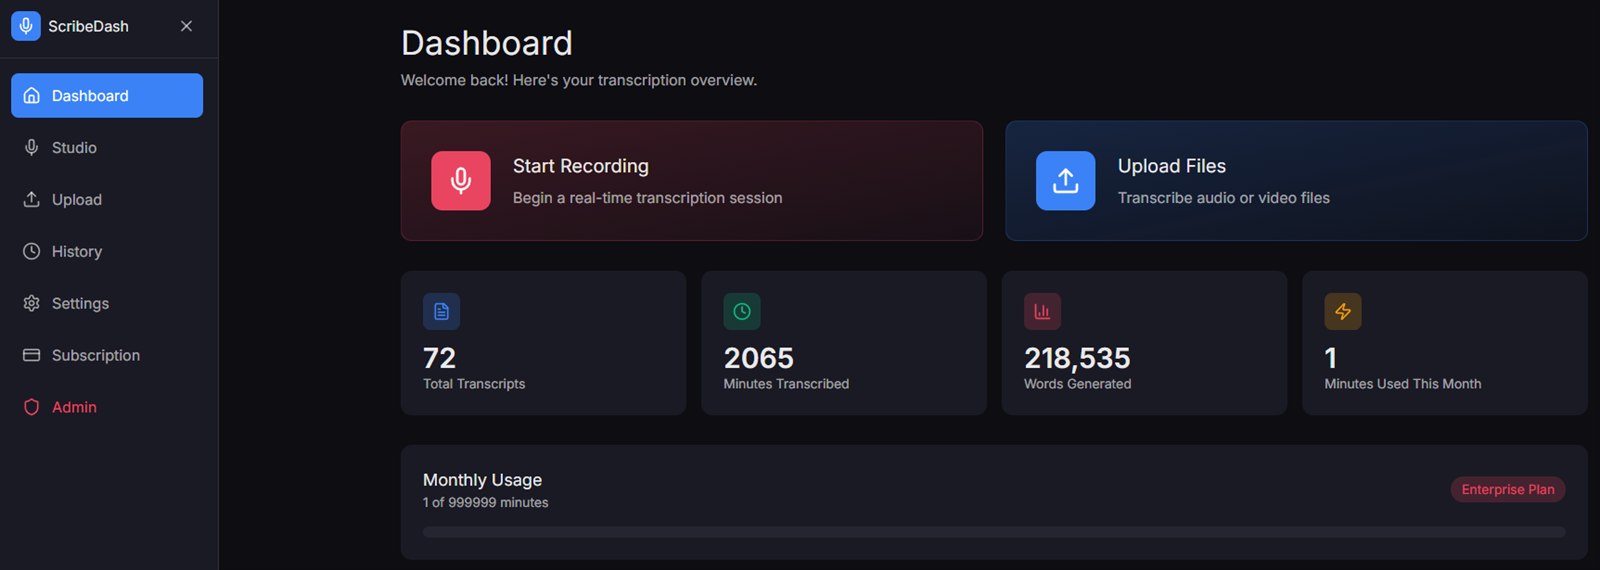
O seu painel de transcrição
Uma visão geral das transcrições, dos minutos transcritos e das palavras geradas, com ações rápidas para gravar ou carregar.
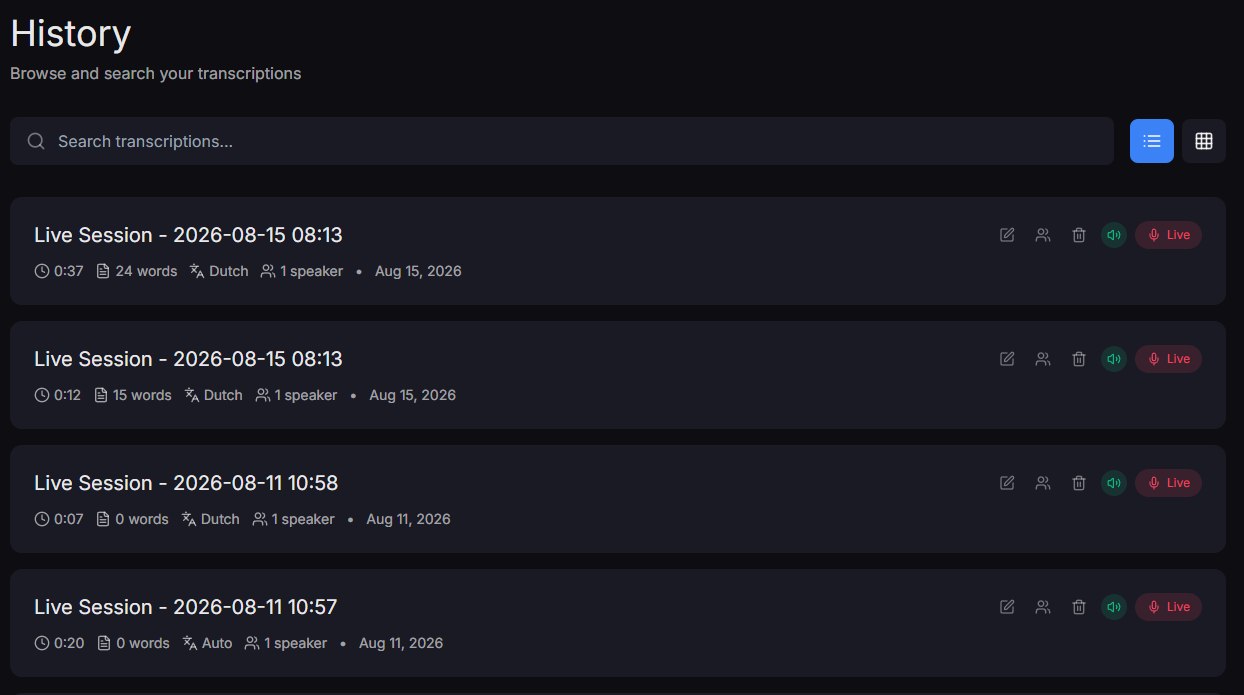
Histórico pesquisável
Cada sessão guardada, pesquisável e identificada por idioma, duração e oradores.
Projeto
ScribeDash
Tipo
Aplicação web de transcrição em tempo real
Tecnologia
React, WebSockets, GPU inference
Ano
2025
Porque criei o ScribeDash
Como secretário de uma direção, redigia regularmente atas de reuniões, por isso sei o valor que tem ter o áudio gravado ao lado do texto transcrito para verificar, palavra por palavra, o que foi realmente dito. O problema: a transcrição integrada no Office 365 era francamente inutilizável, e o Copilot no Teams esgotava-me depressa sem grande utilidade, por isso decidi simplesmente criar a minha própria solução.
Foi assim que criei o ScribeDash: uma aplicação web de transcrição online, em tempo real. Ligue um microfone, comece a gravar e as suas palavras aparecem em texto instantaneamente, com identificação de orador para que veja quem disse o quê. Também pode carregar ficheiros de áudio ou vídeo existentes, ou voltar a passar uma gravação guardada pelo pipeline para a transcrever novamente.
Tudo corre na minha própria infraestrutura soberana, que giro de ponta a ponta. O texto transcrito de outros utilizadores nunca me é visível, por isso é uma forma genuinamente privada e segura de lidar com gravações sensíveis: pense em municípios, reuniões confidenciais e gravação de clientes para atas literais.
O que faz
Transcrição em tempo real
Fale e veja o texto surgir em menos de um segundo, sem esperar por carregamentos ou processamento em lote.
Reconhecimento de orador
Identificação automática de oradores (Speaker 1, Speaker 2, ...) para que atas e entrevistas sejam fáceis de seguir.
GPU inference própria
Os modelos de IA correm no meu próprio hardware, por isso não há dependência de APIs de transcrição externas nem qualquer dado sai da minha infraestrutura soberana.
Multilingue
Transcreva em muitos idiomas, com um seletor de idioma claro para que o modelo saiba exatamente o que esperar.
Carregamento de áudio e vídeo
Não apenas ao vivo: carregue ficheiros de áudio ou vídeo existentes e receba de volta uma transcrição completa, identificada por orador.
Voltar a transcrever quando quiser
Passe novamente uma gravação guardada pelo pipeline, por exemplo com um idioma diferente ou um modelo melhorado, sem gravar nada de novo.
A parte mais difícil: multilingue, sem se desviar
O maior desafio foi ligar um modelo de linguagem de IA que lide bem com vários idiomas.
O problema: assim que escolhe um idioma, o modelo tem de se manter fiel a ele. Uma configuração ingénua desviava-se, uma frase em neerlandês com uma palavra em inglês podia de repente mudar toda a transcrição para outro idioma a meio da sessão. Para atas que precisam de ser literais, isso é inaceitável.
Como o resolvi
Bloqueio explícito de idioma
O idioma selecionado é fixado para toda a sessão e passado ao modelo em cada segmento de áudio, em vez de o deixar detetar automaticamente por fragmento.
Inferência em streaming na GPU
O áudio é transmitido para a minha própria GPU em pequenos segmentos, por isso os resultados são quase instantâneos, mantendo-se consistentes com o idioma bloqueado.
Pós-processamento com reconhecimento de orador
As transcrições são unidas e identificadas por orador, para que o resultado no idioma bloqueado se mantenha limpo e legível.
O resultado: escolha neerlandês e mantém-se neerlandês, mesmo com uma palavra ocasional em inglês, por isso a transcrição corresponde ao que foi realmente dito.
O resultado em números
<1s
Latência da fala ao texto
99+
Idiomas suportados
100%
Nuvem soberana, sem acesso de terceiros
O resultado
O ScribeDash transforma uma tarefa fastidiosa, redigir atas literais, em algo que acontece ao vivo. Durante uma reunião já vê a transcrição a formar-se e, depois, pode reproduzir o áudio ao lado do texto exato.
Como tudo corre na minha própria infraestrutura soberana e autogerida, e ninguém (nem mesmo eu) consegue ver as transcrições de outros utilizadores, mantém-se rápido, privado e seguro, mesmo para os temas mais sensíveis.
Ao vivo
O texto surge enquanto fala
Literal
Áudio e texto lado a lado
Privado
Corre em GPU própria, sem API externa
Nos bastidores
Quer algo assim?
De aplicações de IA em tempo real a modelos self-hosted no seu próprio hardware: se consegue imaginá-lo, eu consigo construí-lo.