自建 SaaS · 实时 AI
ScribeDash
一款实时语音转文字 Web 应用,在你说话的同时将现场音频转化为准确、带发言人标注的文字记录。接上麦克风,点击录制,即可看到文字瞬间浮现,由运行在我自有 GPU inference 上的 AI 驱动。
走进 ScribeDash
从落地页到实时录制工作室。
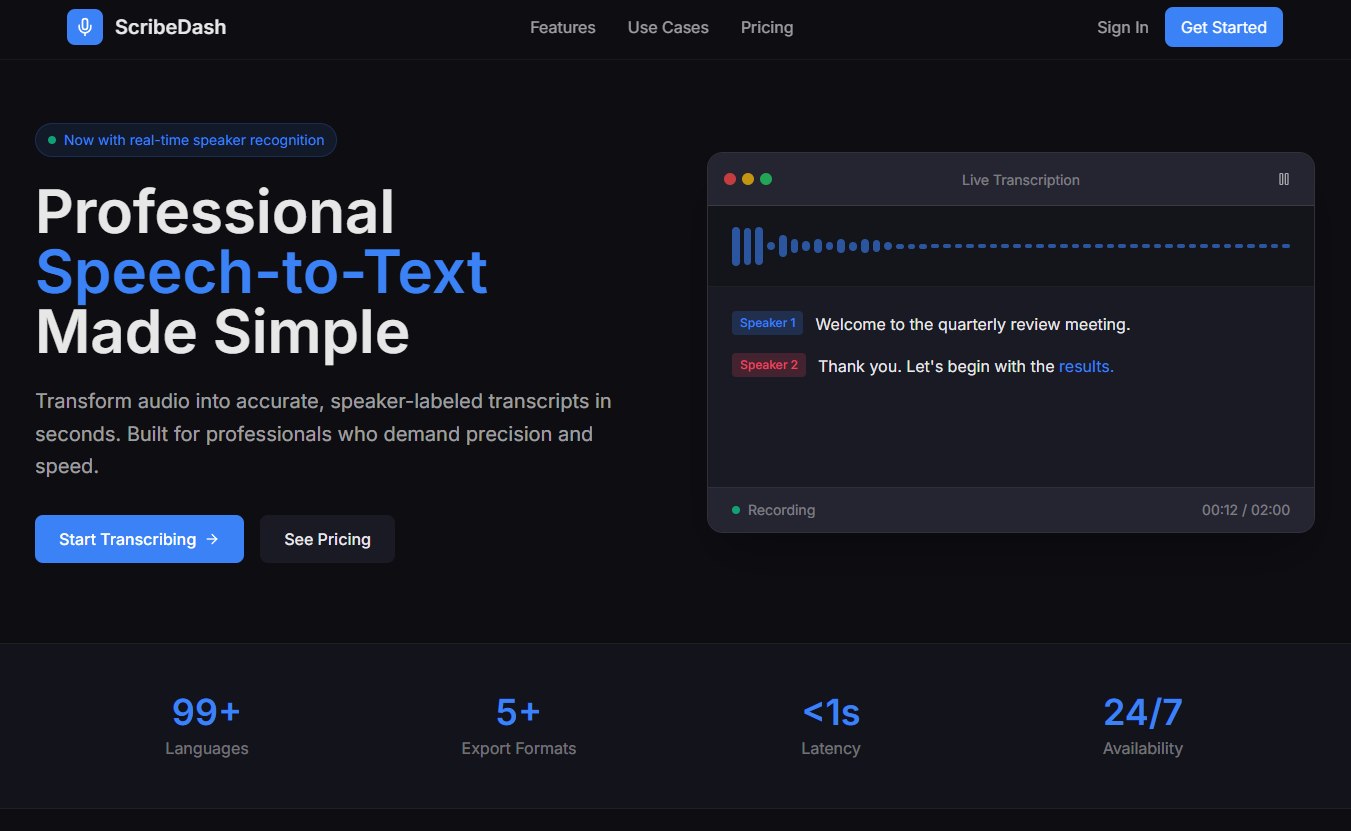
专业级语音转文字
落地页:几秒内将音频转化为准确、带发言人标注的文字记录。
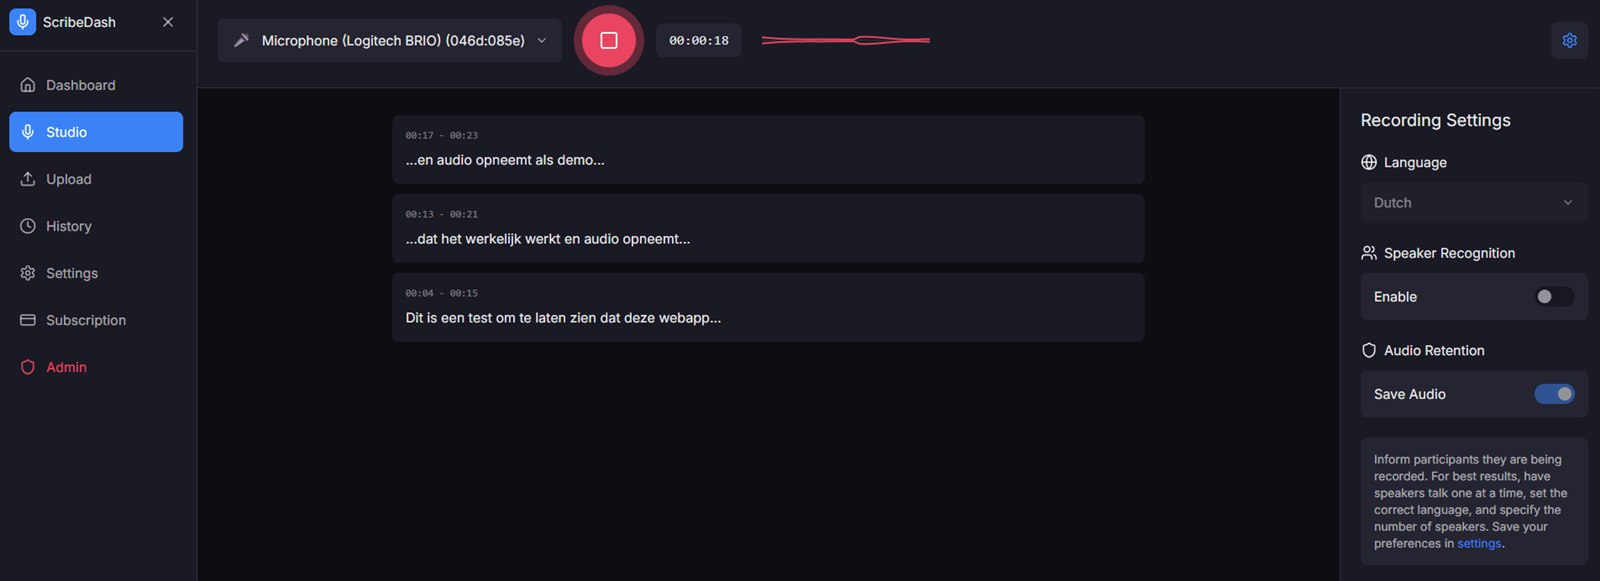
实时录制工作室
从任意麦克风录制,实时观看文字记录流式呈现,并可设置语言与发言人识别。
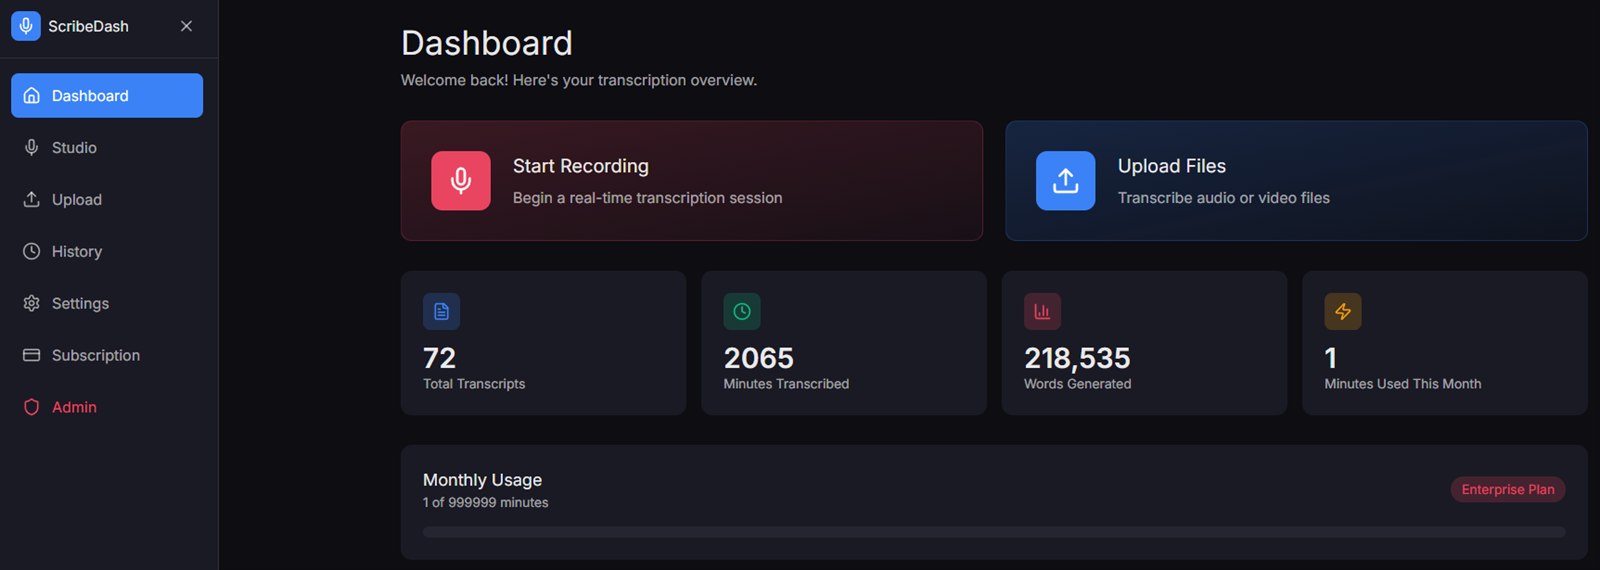
你的转录仪表盘
文字记录、已转录分钟数与生成字数的总览,并提供录制或上传的快捷操作。
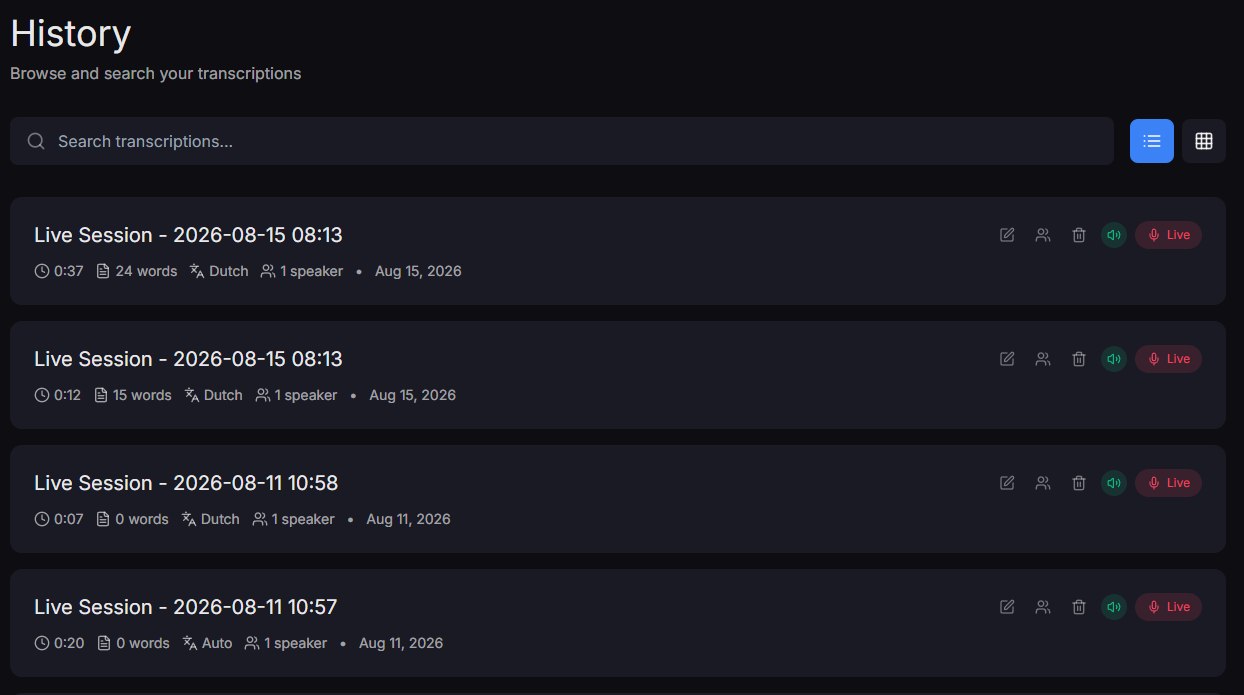
可搜索的历史记录
每次会话都会保存,可按语言、时长和发言人搜索与标注。
项目
ScribeDash
类型
实时转录 Web 应用
技术
React, WebSockets, GPU inference
年份
2025
我为什么打造 ScribeDash
作为董事会秘书,我经常需要撰写会议纪要,因此深知能把录制的音频与转录的文字放在一起、逐字核对当时真正说了什么有多宝贵。问题在于:Office 365 内置的转录功能说实话根本没法用,而 Teams 里的 Copilot 很快就让我筋疲力尽却帮不上多少忙,于是我决定干脆自己动手做一个。
于是我打造了 ScribeDash:一款在线的实时转录 Web 应用。接上麦克风,开始录制,你说出的话便会即时化为文字,并带有发言人标注,让你一眼看清谁说了什么。你还可以上传已有的音频或视频文件,或将已保存的录音再次送入流程重新转录。
一切都运行在我自主掌控、端到端自行管理的 sovereign 基础设施上。其他用户转录的文字我永远无法看到,因此这是一种真正私密、安全的方式来处理敏感录音:想想市政机构、机密会议,以及为逐字纪要而录制的客户场景。
它能做什么
实时转录
开口说话,文字在一秒内浮现,无需等待上传或批量处理。
发言人识别
自动标注发言人(Speaker 1、Speaker 2……),让纪要和访谈易于跟读。
自有 GPU inference
AI 模型运行在我自己的硬件上,因此不依赖外部转录 API,数据也绝不会离开我的 sovereign 基础设施。
多语言支持
可转录多种语言,并配有清晰的语言选择器,让模型准确知道该预期什么。
上传音频与视频
不仅限于实时:直接拖入已有的音频或视频文件,即可获得完整、带发言人标注的文字记录。
按需重新转录
无需重新录制,即可将已保存的录音再次送入流程,例如换用不同语言或改进后的模型。
最难之处:多语言而不跑偏
最棘手的挑战,是接入一个能出色处理多种语言的 AI 语言模型。
问题在于:一旦选定语言,模型就必须坚守到底。粗糙的方案会跑偏,一句荷兰语中夹带一个英文单词,就可能让整段转录在会话中途突然切换到另一种语言。对于需要逐字准确的纪要来说,这是无法接受的。
我如何解决
显式锁定语言
所选语言在整场会话中被固定,并随每个音频片段传给模型,而不是让它逐段自动检测。
GPU 上的流式推理
音频以小片段的形式流式传输到我自己的 GPU,因此结果近乎即时,同时与锁定的语言保持一致。
感知发言人的后处理
文字记录被拼接并按发言人标注,让锁定语言的输出保持干净、易读。
结果是:选择荷兰语,它就一直是荷兰语,即便偶尔夹带英文单词,转录也能与当时真正说出的话相符。
用数字说话
<1s
从说话到文字的延迟
99+
支持的语言数
100%
sovereign 云端,无第三方访问
成果
ScribeDash 把撰写逐字纪要这件繁琐的事,变成了实时发生的过程。会议进行中你就已经看到文字记录逐步生成,会后还能一边回放音频、一边对照精确的文字。
由于一切都运行在我自主、自行管理的 sovereign 基础设施上,且没有人(连我也不例外)能看到其他用户的文字记录,因此即便面对最敏感的话题,它依然快速、私密且安全。
实时
说话的同时文字浮现
逐字
音频与文字并排呈现
私密
运行在自有 GPU,无外部 API