Собственный SaaS · AI в реальном времени
ScribeDash
Веб-приложение для распознавания речи в реальном времени, которое превращает живой звук в точные транскрипты с разметкой по говорящим прямо во время речи. Подключите микрофон, нажмите запись и наблюдайте, как слова появляются мгновенно, благодаря AI, работающему на моём собственном GPU inference.
Взгляд изнутри ScribeDash
От посадочной страницы до студии записи в реальном времени.
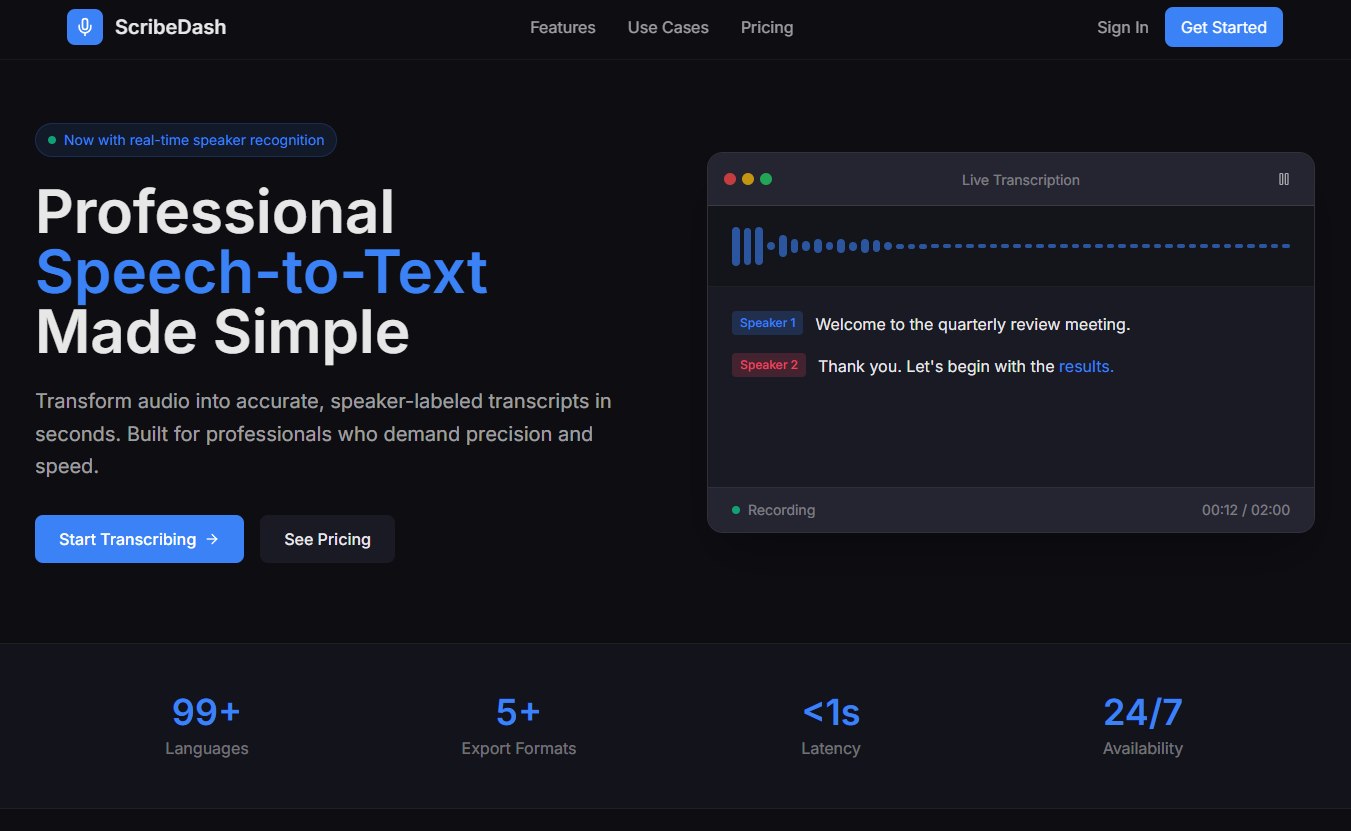
Профессиональное распознавание речи
Посадочная страница: превращайте звук в точные транскрипты с разметкой по говорящим за секунды.
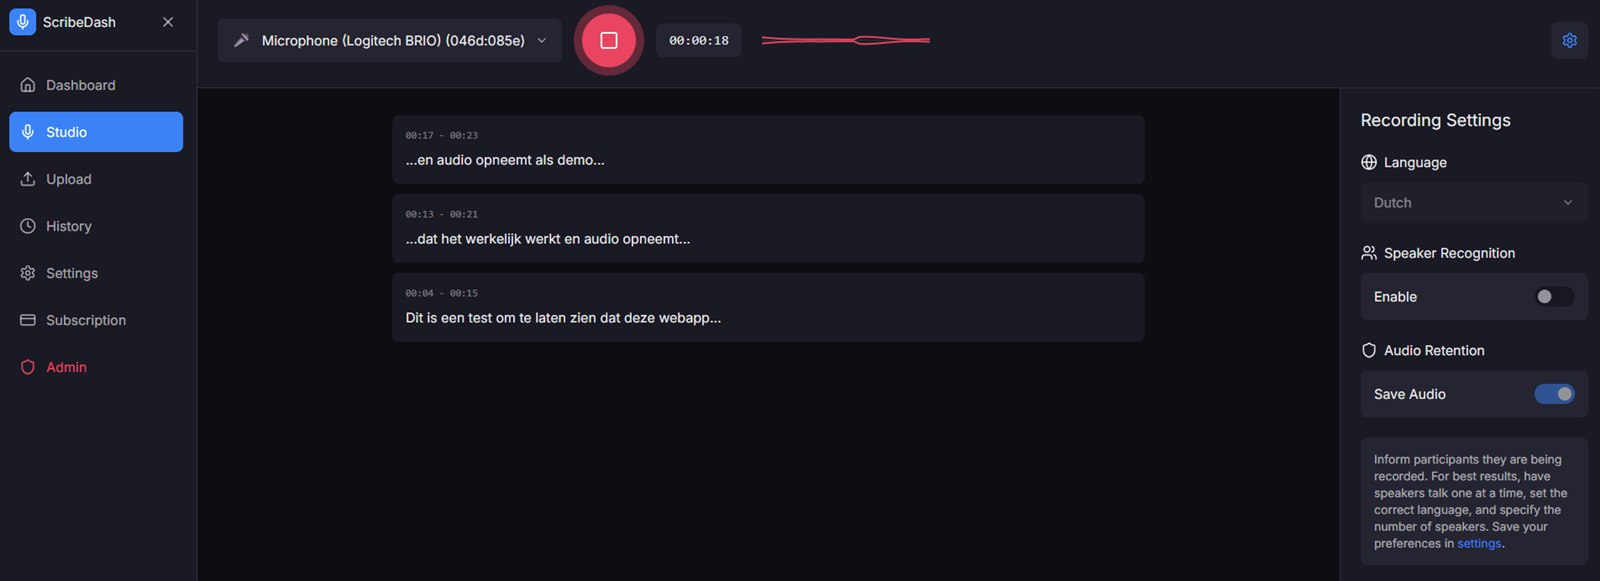
Студия записи в реальном времени
Записывайте с любого микрофона и наблюдайте, как транскрипт появляется в реальном времени, с настройками языка и распознавания говорящих.
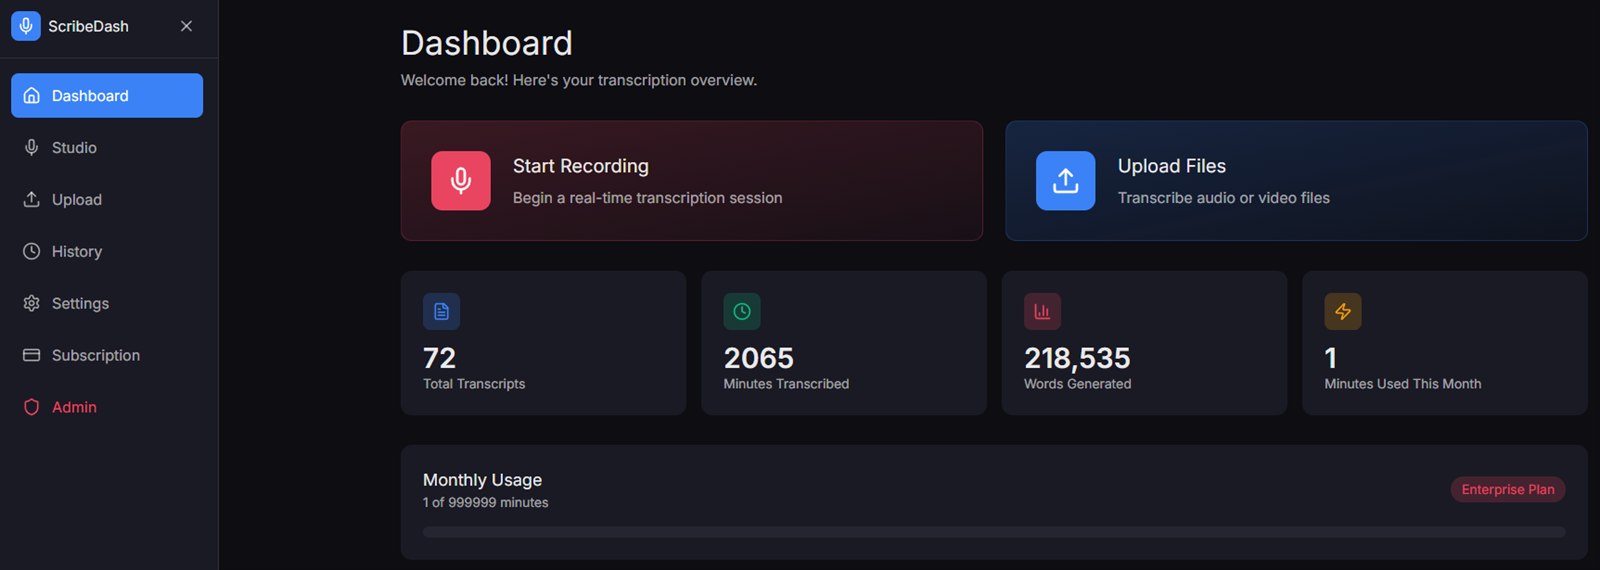
Ваша панель транскрипций
Обзор транскриптов, расшифрованных минут и созданных слов, с быстрыми действиями для записи или загрузки.
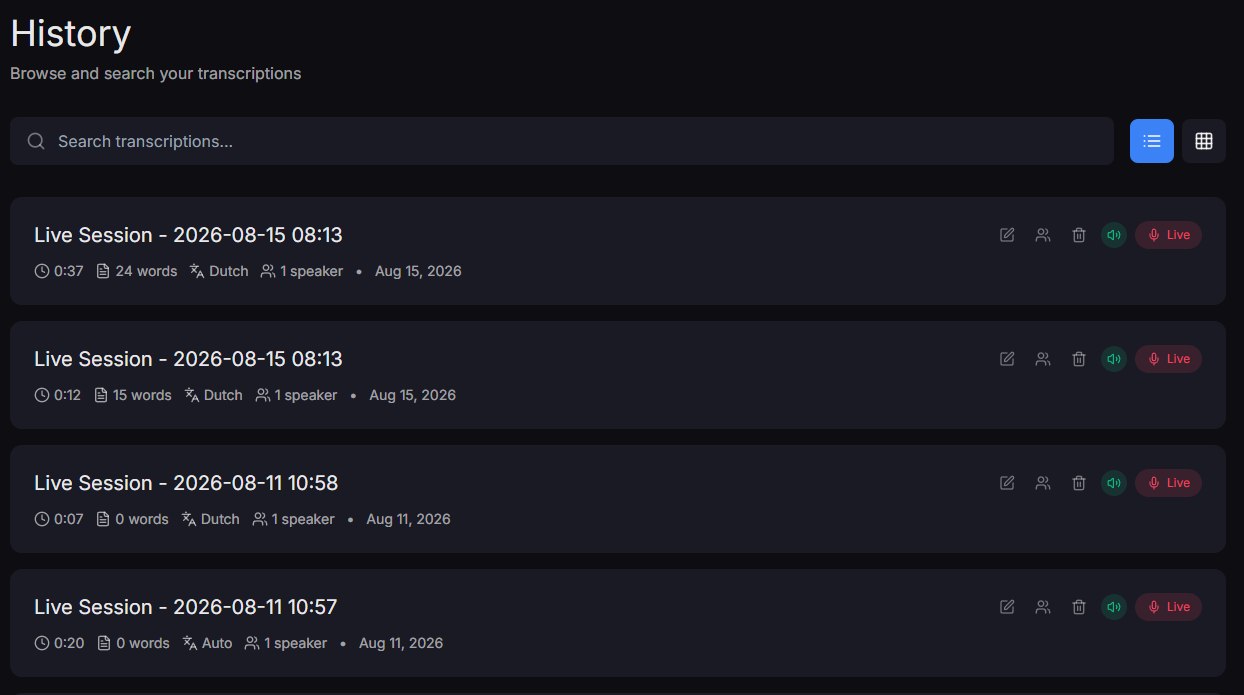
История с поиском
Каждая сессия сохранена, доступна для поиска и размечена по языку, длительности и говорящим.
Проект
ScribeDash
Тип
Веб-приложение для транскрипции в реальном времени
Технологии
React, WebSockets, GPU inference
Год
2025
Почему я создал ScribeDash
Как секретарь правления я регулярно составлял протоколы заседаний, поэтому знаю, насколько ценно иметь записанный звук рядом с расшифрованным текстом, чтобы дословно проверить, что именно было сказано. Загвоздка в том, что встроенная транскрипция в Office 365 была, честно говоря, непригодна, а Copilot в Teams быстро меня измотал, не принося особой пользы, так что я решил просто создать своё собственное решение.
Так я создал ScribeDash: онлайн веб-приложение для транскрипции в реальном времени. Подключите микрофон, начните запись, и произнесённые вами слова мгновенно появляются в виде текста, с разметкой по говорящим, чтобы было видно, кто что сказал. Также можно загрузить существующие аудио- или видеофайлы либо снова прогнать сохранённую запись через конвейер, чтобы расшифровать её заново.
Всё работает на моей собственной суверенной инфраструктуре, которой я управляю от начала до конца. Расшифрованный текст других пользователей мне никогда не виден, поэтому это по-настоящему приватный и безопасный способ работать с конфиденциальными записями: например, для муниципалитетов, закрытых заседаний и записи клиентов для дословных протоколов.
Что оно умеет
Транскрипция в реальном времени
Говорите и видите, как текст появляется в течение секунды, без ожидания загрузок или пакетной обработки.
Распознавание говорящих
Автоматическая разметка говорящих (Speaker 1, Speaker 2, ...), чтобы протоколы и интервью было легко читать.
Собственный GPU inference
AI-модели работают на моём собственном оборудовании, поэтому нет зависимости от внешних API транскрипции и никакие данные никогда не покидают мою суверенную инфраструктуру.
Многоязычность
Транскрибируйте на множестве языков, с понятным выбором языка, чтобы модель точно знала, чего ожидать.
Загрузка аудио и видео
Не только вживую: добавьте существующие аудио- или видеофайлы и получите полный транскрипт с разметкой по говорящим.
Повторная транскрипция по запросу
Снова прогоните сохранённую запись через конвейер, например с другим языком или улучшенной моделью, не записывая ничего нового.
Самое сложное: многоязычность без сбоев
Самой трудной задачей было настроить AI-модель, которая хорошо справляется с несколькими языками.
Загвоздка в том, что как только вы выбрали язык, модель должна его придерживаться. Наивная настройка сбивалась бы: голландское предложение с одним английским словом могло внезапно переключить всю транскрипцию на другой язык посреди сессии. Для протоколов, которые должны быть дословными, это недопустимо.
Как я это решил
Явная фиксация языка
Выбранный язык закрепляется на всю сессию и передаётся модели с каждым фрагментом звука, вместо того чтобы позволять ей автоопределять язык для каждого фрагмента.
Потоковый inference на GPU
Звук передаётся на мой собственный GPU небольшими фрагментами, поэтому результаты появляются почти мгновенно, оставаясь согласованными с закреплённым языком.
Постобработка с учётом говорящих
Транскрипты сшиваются вместе и размечаются по говорящим, поэтому вывод на закреплённом языке остаётся чистым и читаемым.
Результат: выберите голландский, и он останется голландским, даже с редким английским словом, поэтому транскрипт соответствует тому, что было сказано на самом деле.
Результат в цифрах
<1s
Задержка от речи до текста
99+
Поддерживаемых языков
100%
Суверенное облако, без доступа третьих лиц
Итог
ScribeDash превращает утомительную задачу, написание дословных протоколов, в то, что происходит вживую. Во время заседания вы уже видите, как строится транскрипт, а потом можете воспроизвести звук рядом с точным текстом.
Поскольку всё работает на моей собственной суверенной, самостоятельно управляемой инфраструктуре, и никто (даже я) не может видеть транскрипты других пользователей, это остаётся быстрым, приватным и безопасным даже для самых чувствительных тем.
Вживую
Текст появляется, пока вы говорите
Дословно
Звук и текст рядом друг с другом
Приватно
Работает на собственном GPU, без внешнего API
Под капотом
Хотите что-то подобное?
От AI-приложений в реальном времени до self-hosted моделей на вашем собственном оборудовании: если вы можете это придумать, я могу это создать.