Zelfgebouwde SaaS · Realtime AI
ScribeDash
Een realtime speech-to-text webapp die live audio omzet in accurate, van sprekerlabels voorziene transcripties terwijl je praat. Sluit een microfoon aan, druk op opnemen, en de woorden verschijnen direct, aangedreven door AI op mijn eigen GPU-inference.
Een kijkje in ScribeDash
Van landingspagina tot de live opnamestudio.
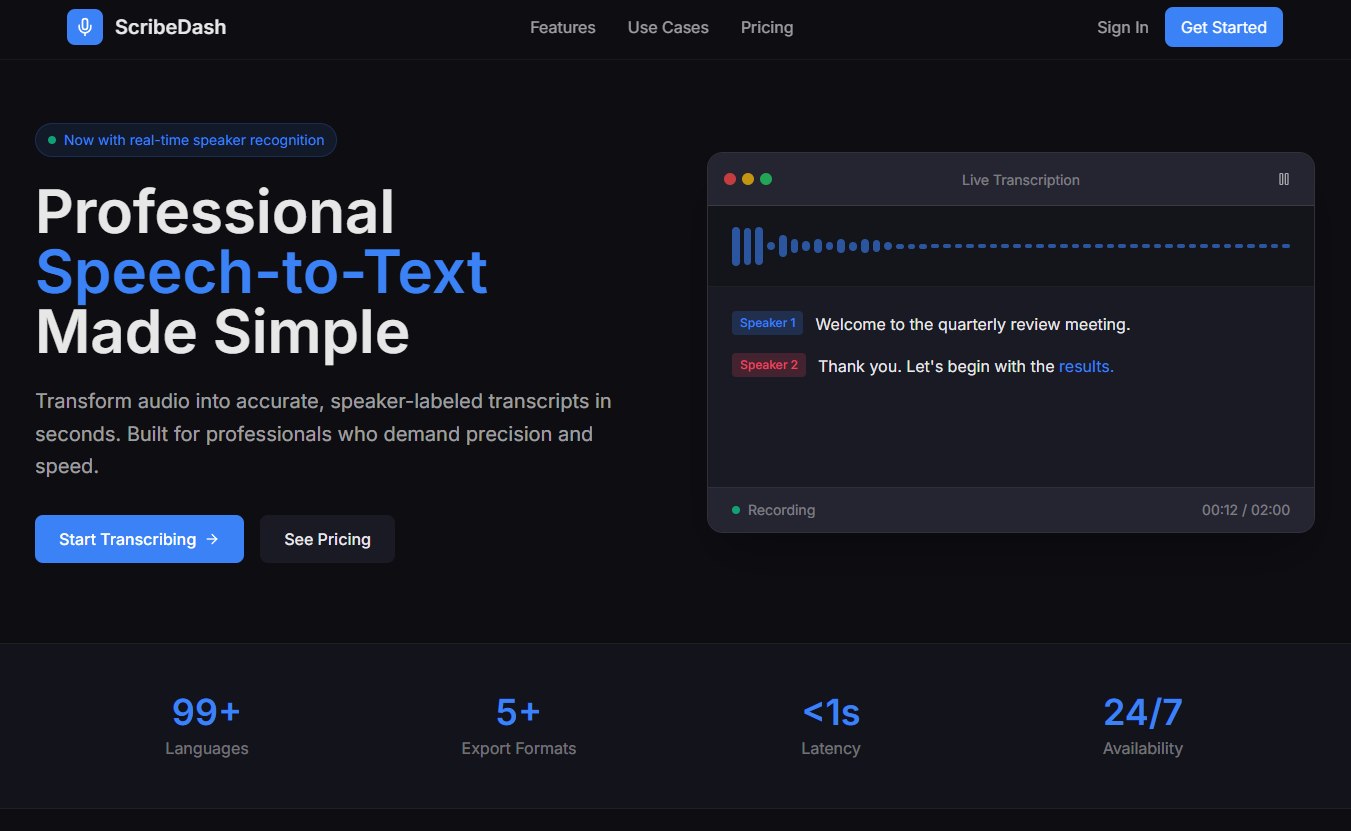
Professionele speech-to-text
De landingspagina: zet audio in seconden om in accurate, van sprekerlabels voorziene transcripties.
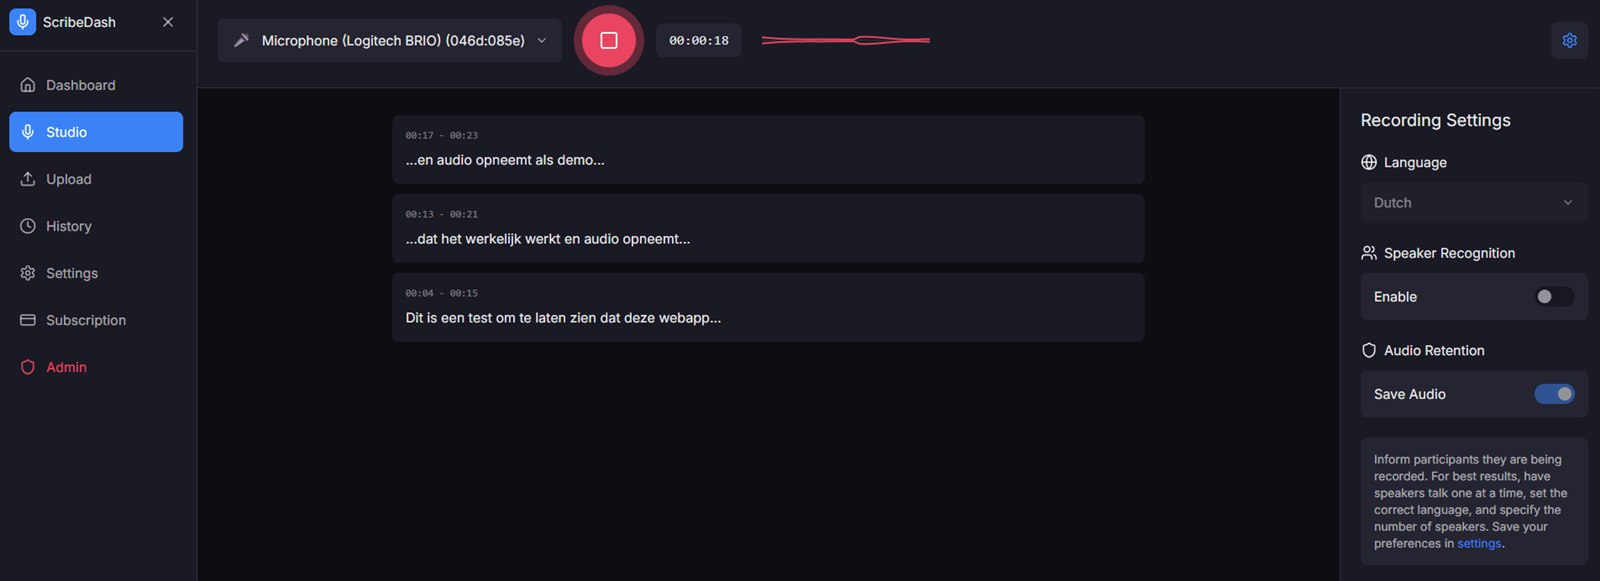
Live opnamestudio
Neem op met elke microfoon en zie de transcriptie in realtime binnenkomen, met instellingen voor taal en sprekerherkenning.
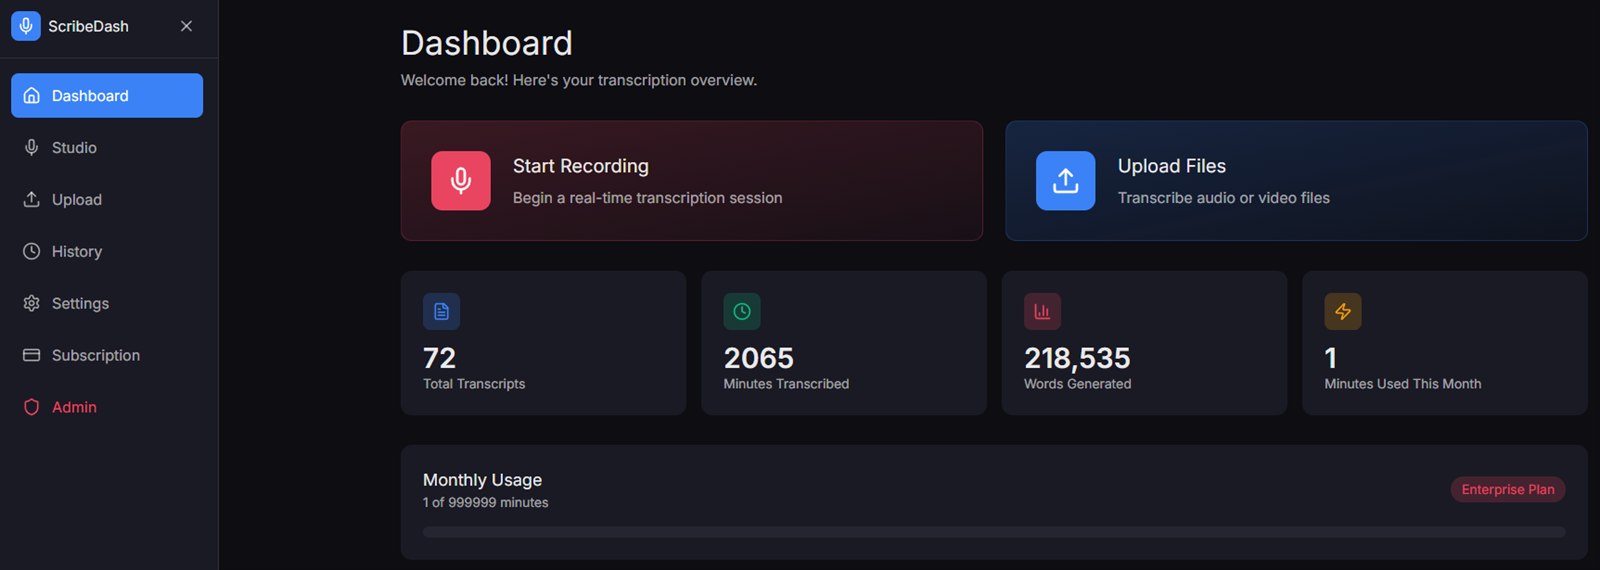
Je transcriptie-dashboard
Een overzicht van transcripties, opgenomen minuten en gegenereerde woorden, met snelknoppen om op te nemen of te uploaden.
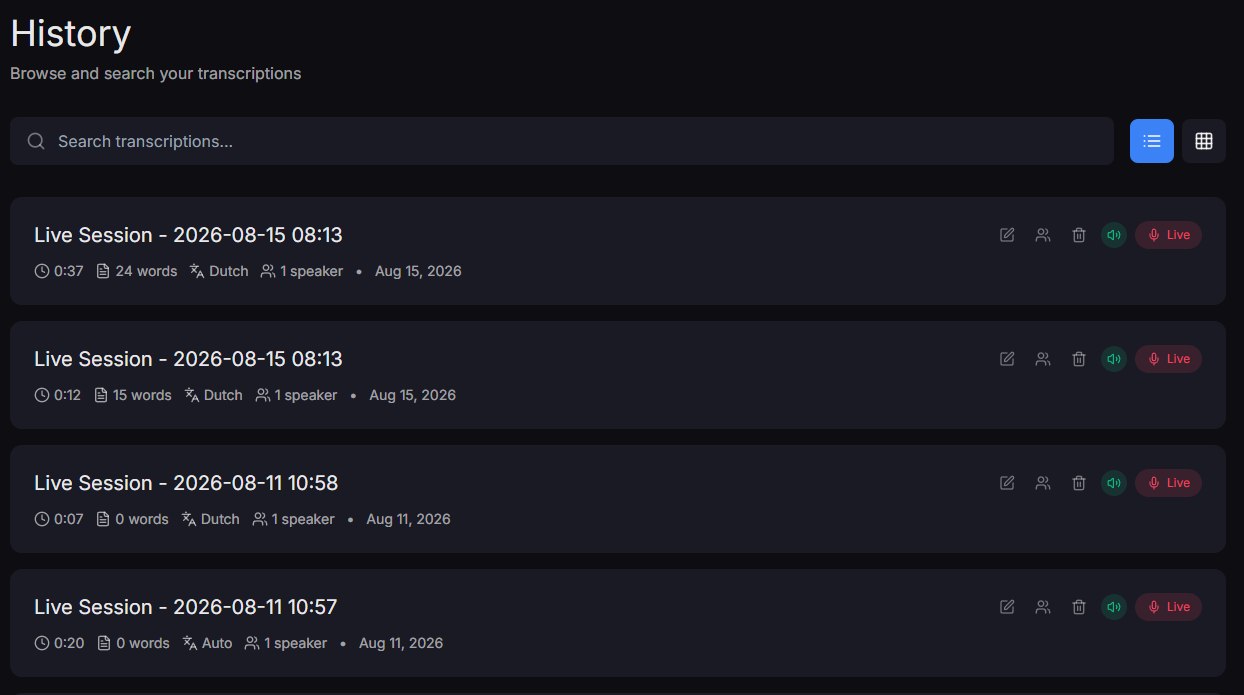
Doorzoekbare geschiedenis
Elke sessie opgeslagen, doorzoekbaar en gelabeld op taal, duur en sprekers.
Project
ScribeDash
Type
Realtime transcriptie-webapp
Technologie
React, WebSockets, GPU inference
Jaar
2025
Waarom ik ScribeDash bouwde
Als secretaris maakte ik regelmatig notulen, dus ik weet hoe waardevol het is om de opgenomen audio náást de omgezette tekst te hebben om woordelijk na te gaan wat er precies is gezegd. Alleen: de transcriptie in Office 365 was ronduit onbruikbaar, en van Copilot in Teams werd ik snel moe zonder er veel aan te hebben, dus heb ik het zelf maar gebouwd.
Dus bouwde ik ScribeDash: een online, realtime transcriptie-webapp. Sluit een microfoon aan, start de opname, en je gesproken woorden verschijnen direct als tekst, met sprekerlabels zodat je ziet wie wat zei. Je kunt ook bestaande audio- of videobestanden uploaden, of een opgeslagen opname nogmaals door de molen halen om opnieuw te laten transcriberen.
Alles draait op mijn eigen soevereine infrastructuur, die ik volledig zelf beheer. De getranscribeerde tekst van andere gebruikers is voor mij nooit inzichtelijk, waardoor het een echt privé en veilige manier is om gevoelige opnames te verwerken: denk aan gemeentes, vertrouwelijke vergaderingen en het opnemen van klanten voor woordelijke notulen.
Wat het doet
Realtime transcriptie
Praat en zie de tekst binnen een seconde verschijnen, geen wachten op uploads of batchverwerking.
Sprekerherkenning
Automatische sprekerlabels (Spreker 1, Spreker 2, ...) zodat notulen en interviews makkelijk te volgen zijn.
Eigen GPU-inference
De AI-modellen draaien op eigen hardware, dus geen afhankelijkheid van externe transcriptie-APIs en er verlaat nooit data mijn soevereine infrastructuur.
Meertalig
Transcribeer in veel talen, met een duidelijke taalkiezer zodat het model precies weet wat het kan verwachten.
Audio & video uploaden
Niet alleen live: sleep bestaande audio- of videobestanden erin en krijg een volledige, van sprekerlabels voorziene transcriptie terug.
Opnieuw transcriberen
Haal een opgeslagen opname nogmaals door de molen, bijvoorbeeld met een andere taal of een verbeterd model, zonder iets nieuws op te nemen.
Het lastigste: meertalig, zonder afdwalen
De grootste uitdaging was het aansluiten van een AI-taalmodel dat meerdere talen goed aankan.
De valkuil: zodra je een taal kiest, moet het model zich daaraan houden. Een naïeve opzet gaat afdwalen, een Nederlandse zin met één Engels woord kan de hele transcriptie ineens naar een andere taal laten omslaan. Voor notulen die woordelijk moeten kloppen is dat onacceptabel.
Hoe ik het heb opgelost
Expliciete taal-vergrendeling
De gekozen taal wordt voor de hele sessie vastgezet en bij elk audiofragment aan het model meegegeven, in plaats van per fragment automatisch te laten detecteren.
Streaming inference op GPU
Audio wordt in kleine stukjes naar mijn eigen GPU gestreamd, zodat resultaten vrijwel direct zijn én consistent blijven met de vastgezette taal.
Spreker-bewuste nabewerking
Transcripties worden per spreker samengevoegd en gelabeld, zodat de output in de vastgezette taal schoon en leesbaar blijft.
Het resultaat: kies je Nederlands, dan blijft het Nederlands, ook met af en toe een Engels woord, zodat de transcriptie klopt met wat er echt gezegd is.
Het resultaat in cijfers
<1s
Latency van spraak naar tekst
99+
Ondersteunde talen
100%
Soevereine cloud, geen externe toegang
De uitkomst
ScribeDash verandert een vervelende klus, woordelijke notulen maken, in iets wat live gebeurt. Tijdens een vergadering zie je de transcriptie al opbouwen, en achteraf kun je de audio náást de exacte tekst terugluisteren.
Omdat alles op mijn eigen soevereine, zelf-beheerde infrastructuur draait, en niemand (ook ik niet) de transcripties van andere gebruikers kan inzien, blijft het snel, privé en veilig, ook bij de meest gevoelige onderwerpen.
Live
Tekst verschijnt terwijl je praat
Woordelijk
Audio en tekst naast elkaar
Privé
Draait op eigen GPU, geen externe API
Onder de motorkap
Wil je zoiets ook?
Van realtime AI-apps tot zelf-gehoste modellen op je eigen hardware: kun je het bedenken, dan bouw ik het.