自作SaaS · リアルタイムAI
ScribeDash
ライブ音声をその場で、正確な話者ラベル付きの文字起こしに変換するリアルタイム音声認識Webアプリです。マイクを接続して録音を開始すれば、自分のGPU inference上で動くAIによって、話した言葉が即座に画面に表示されます。
ScribeDashの中身を見る
ランディングページからライブ録音スタジオまで。
プロ品質の音声認識
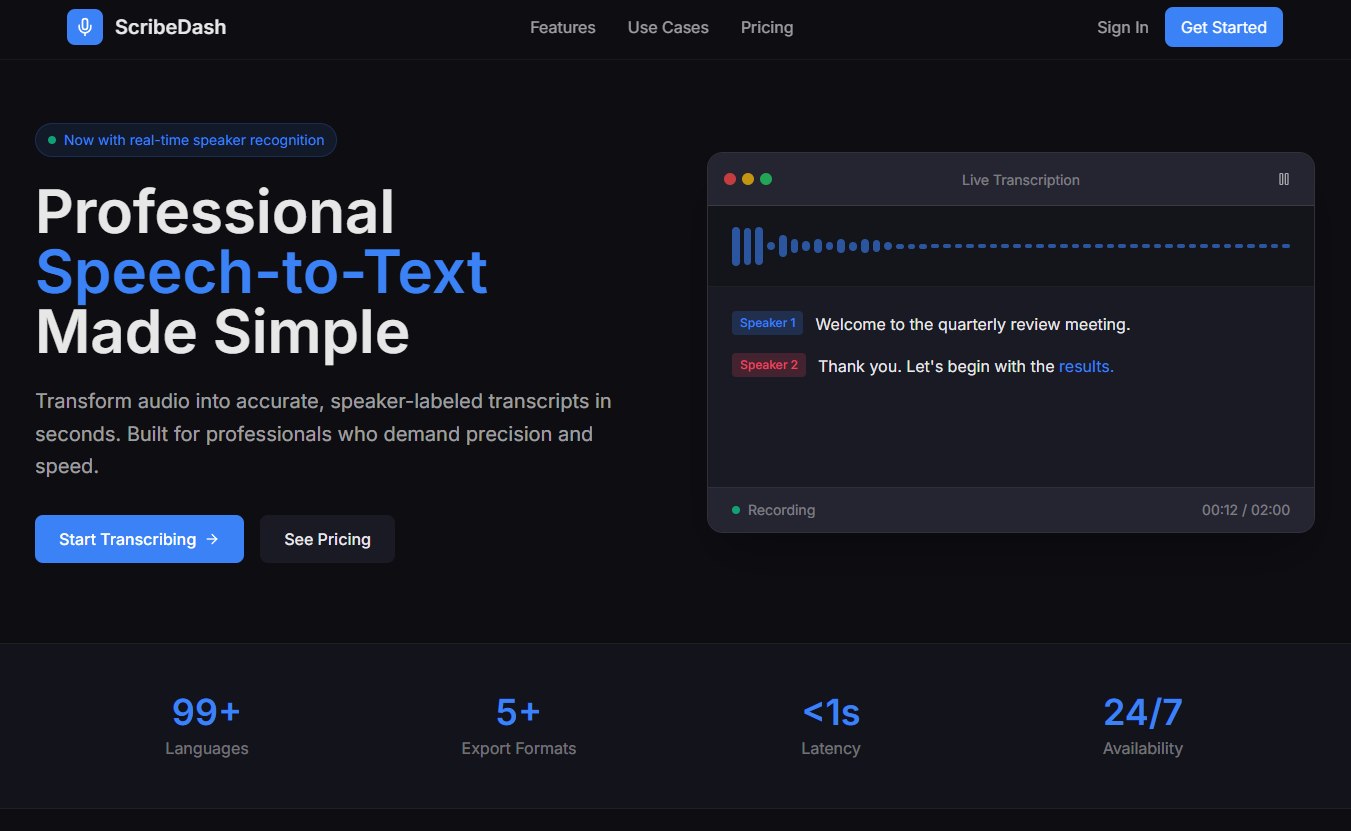
ランディングページ。音声を数秒で正確な話者ラベル付きの文字起こしに変換します。
ライブ録音スタジオ
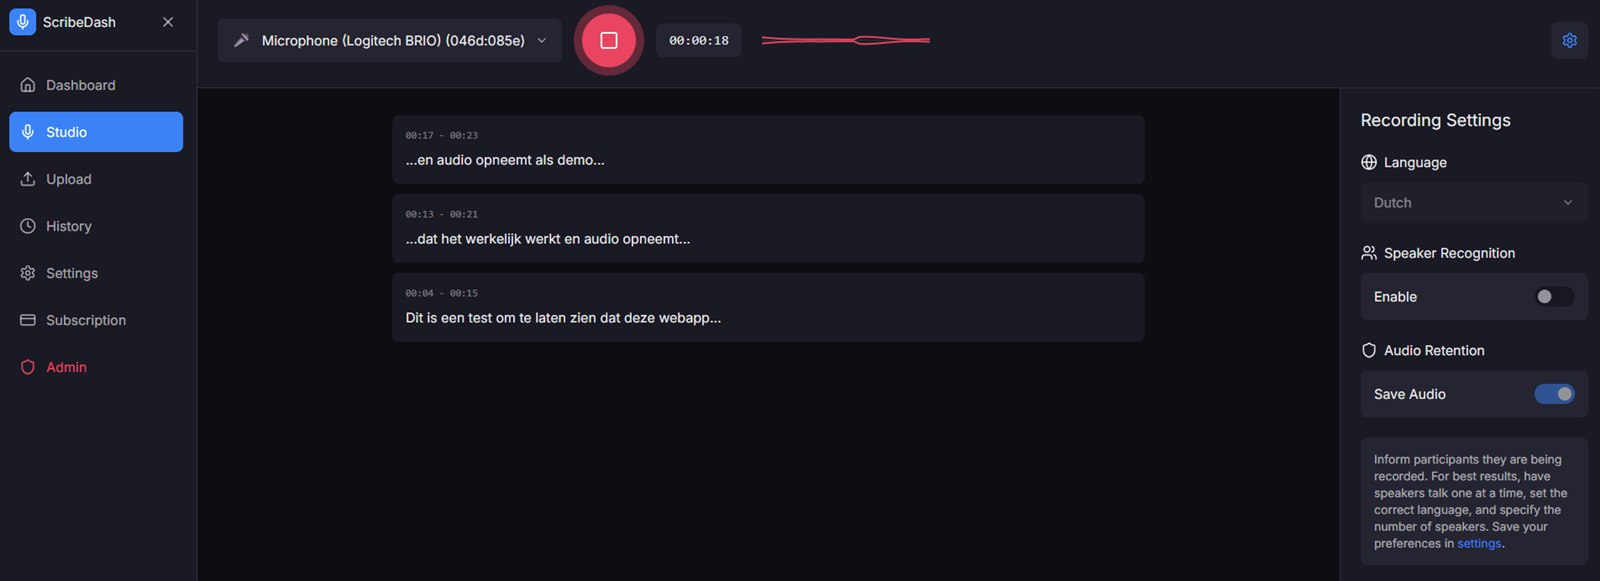
任意のマイクから録音し、言語や話者認識の設定とともに、文字起こしがリアルタイムで流れる様子を確認できます。
文字起こしダッシュボード
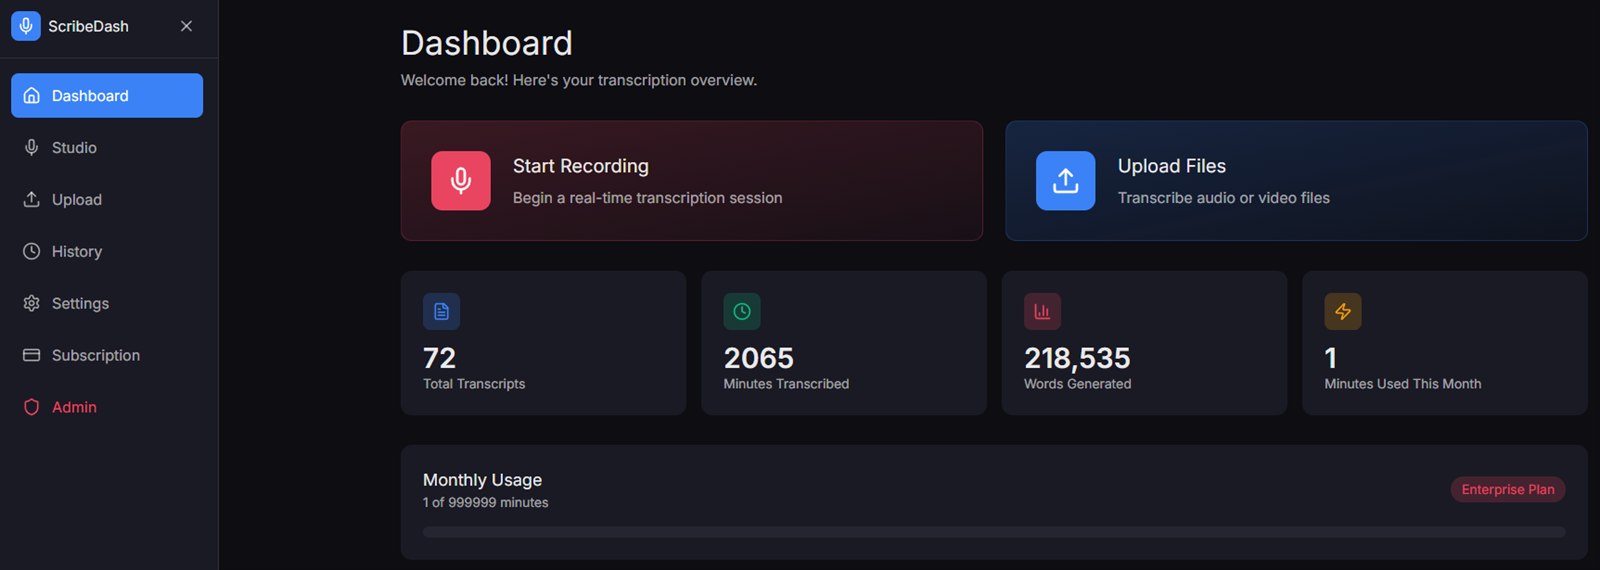
文字起こし一覧、文字起こしした分数、生成した単語数を一覧表示し、録音やアップロードをすぐに実行できます。
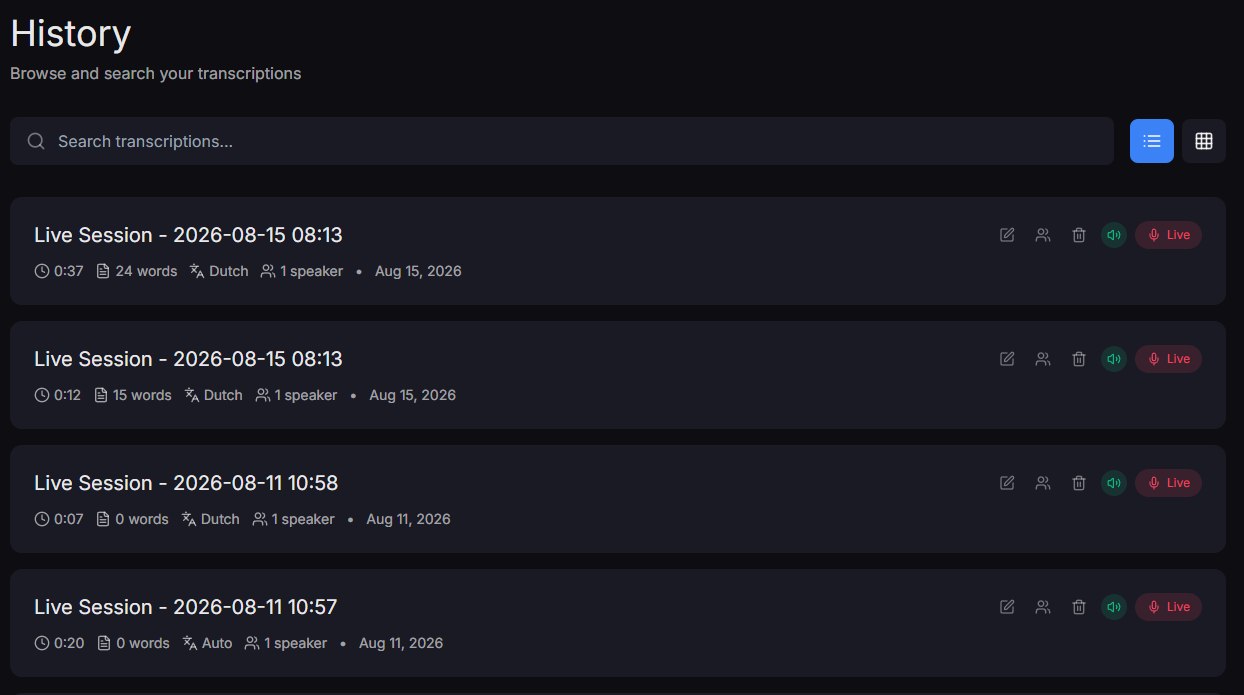
検索できる履歴
すべてのセッションを保存し、言語、長さ、話者でラベル付けして検索できます。
プロジェクト
ScribeDash
種別
リアルタイム文字起こしWebアプリ
技術
React, WebSockets, GPU inference
年
2025
ScribeDashを作った理由
理事の書記として定期的に議事録を作成していたため、実際に何が話されたのかを一言一句確認するうえで、録音音声を文字起こしテキストの横に置けることがどれほど価値があるかを知っています。問題は、Office 365に組み込まれた文字起こしが正直まったく使い物にならず、TeamsのCopilotもたいして役に立たないまますぐに疲れさせられたことでした。そこで、いっそ自分で作ることに決めました。
こうして生まれたのがScribeDashです。オンラインで動作するリアルタイム文字起こしWebアプリで、マイクを接続して録音を始めれば、話した言葉が即座にテキストとして表示され、話者ラベルによって誰が何を言ったのかが一目でわかります。既存の音声ファイルや動画ファイルをアップロードしたり、保存済みの録音をパイプラインに再度通して文字起こしし直したりすることもできます。
すべては私が端から端まで管理する自分のsovereignなインフラ上で動作します。他のユーザーの文字起こしテキストが私に見えることは決してないため、機密性の高い録音を扱うための、本当にプライベートで安全な手段になっています。たとえば自治体、機密会議、逐語議事録のための顧客の録音などです。
できること
リアルタイム文字起こし
話すと1秒以内にテキストが表示され、アップロードやバッチ処理を待つ必要がありません。
話者認識
自動の話者ラベル(Speaker 1、Speaker 2、...)により、議事録やインタビューが追いやすくなります。
自前のGPU inference
AIモデルは自分のハードウェア上で動作するため、外部の文字起こしAPIに依存することがなく、データが私のsovereignなインフラの外に出ることは一切ありません。
多言語対応
多くの言語で文字起こしができ、わかりやすい言語セレクターによってモデルが何を想定すべきかを正確に把握します。
音声・動画のアップロード
ライブだけではありません。既存の音声ファイルや動画ファイルを取り込めば、完全な話者ラベル付きの文字起こしが返ってきます。
オンデマンドで再文字起こし
保存済みの録音をパイプラインにもう一度通せます。たとえば別の言語や改良したモデルで、新たに録音することなく再処理できます。
最も難しかった点。ぶれずに多言語を扱うこと
最大の課題は、複数の言語をうまく扱えるAI言語モデルを組み上げることでした。
問題は、いったん言語を選んだら、モデルがそれを守り続けなければならないことです。素朴な構成ではぶれてしまい、英単語が1つ混じったオランダ語の文が、セッションの途中で突然、文字起こし全体を別の言語に切り替えてしまうことがあります。逐語であるべき議事録にとって、それは受け入れられません。
どう解決したか
明示的な言語ロック
選択した言語をセッション全体で固定し、断片ごとに自動検出させるのではなく、音声チャンクごとにモデルへ渡します。
GPU上でのストリーミング推論
音声を小さなチャンクに分けて自分のGPUへストリーミングするため、ロックした言語との一貫性を保ちながら、ほぼ瞬時に結果が得られます。
話者を意識した後処理
文字起こしを話者ごとに結合してラベル付けするため、ロックした言語の出力がきれいで読みやすいまま保たれます。
その結果、オランダ語を選べば、たまに英単語が混じってもオランダ語のままとなり、実際に話された内容と文字起こしが一致します。
数字で見る成果
<1s
発話からテキストまでの遅延
99+
対応言語数
100%
sovereignクラウド、第三者アクセスなし
得られた成果
ScribeDashは、逐語議事録を書くという面倒な作業を、ライブで起きることに変えます。会議中にはすでに文字起こしが組み上がっていくのが見え、その後は音声を正確なテキストの横で再生できます。
すべてが自分で管理するsovereignなインフラ上で動作し、他のユーザーの文字起こしは誰にも(私自身にも)見えないため、最も機密性の高いテーマであっても、高速でプライベートかつ安全であり続けます。
ライブ
話しながらテキストが表示される
逐語
音声とテキストを並べて表示
プライベート
自前のGPUで動作、外部APIなし