SaaS sviluppato in proprio · AI in tempo reale
ScribeDash
Un'app web di speech-to-text in tempo reale che trasforma l'audio dal vivo in trascrizioni accurate, con l'indicazione di chi parla, mentre parli. Collega un microfono, avvia la registrazione e guarda le parole comparire all'istante, grazie all'AI eseguita sulla mia GPU inference.
Uno sguardo dentro ScribeDash
Dalla landing page allo studio di registrazione dal vivo.
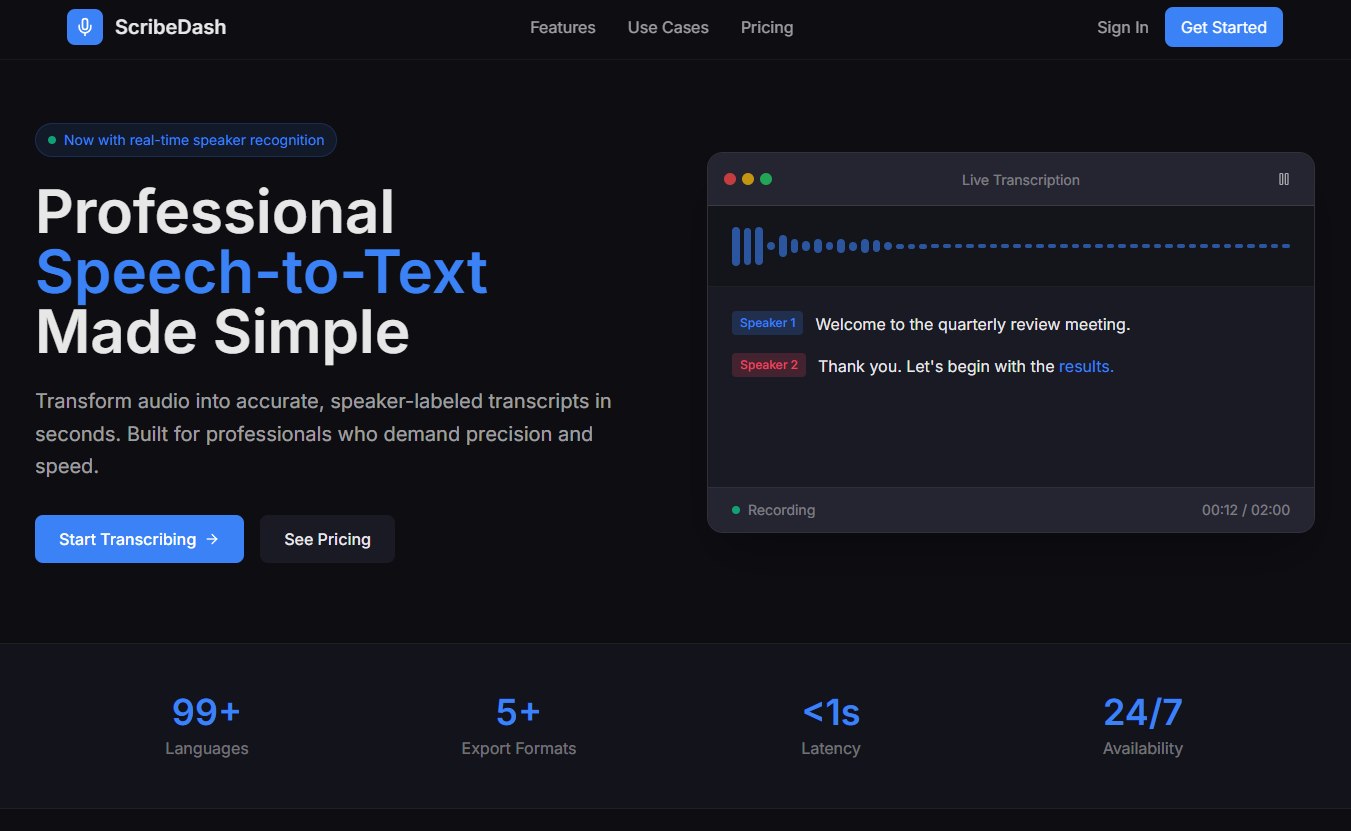
Speech-to-text professionale
La landing page: trasforma l'audio in trascrizioni accurate, con l'indicazione di chi parla, in pochi secondi.
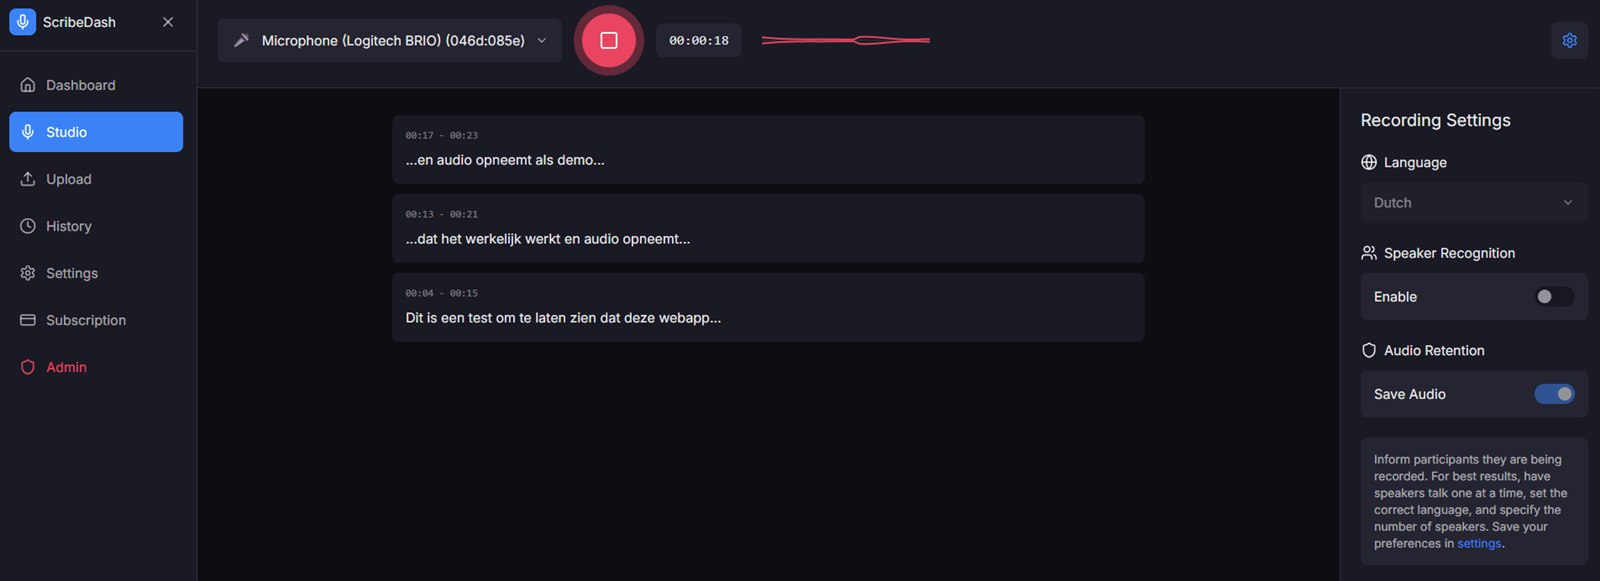
Studio di registrazione dal vivo
Registra da qualsiasi microfono e guarda la trascrizione scorrere in tempo reale, con impostazioni per la lingua e il riconoscimento di chi parla.
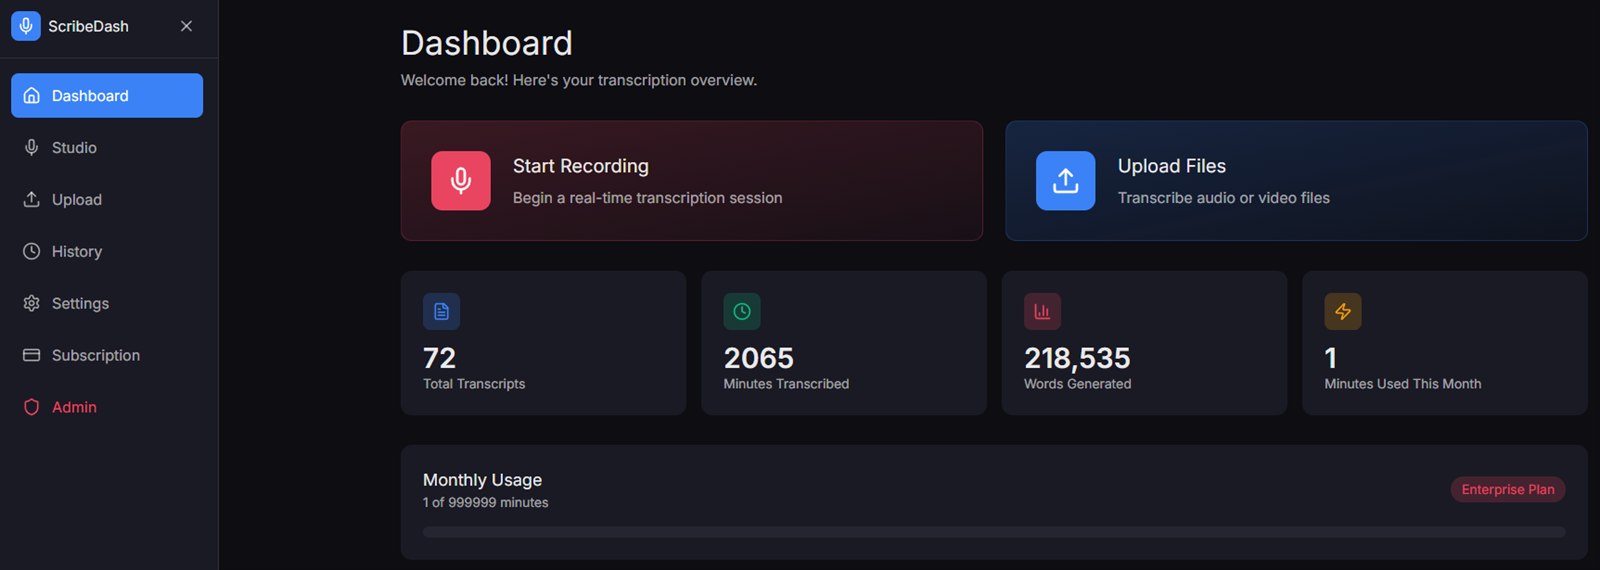
La tua dashboard di trascrizione
Una panoramica delle trascrizioni, dei minuti trascritti e delle parole generate, con azioni rapide per registrare o caricare.
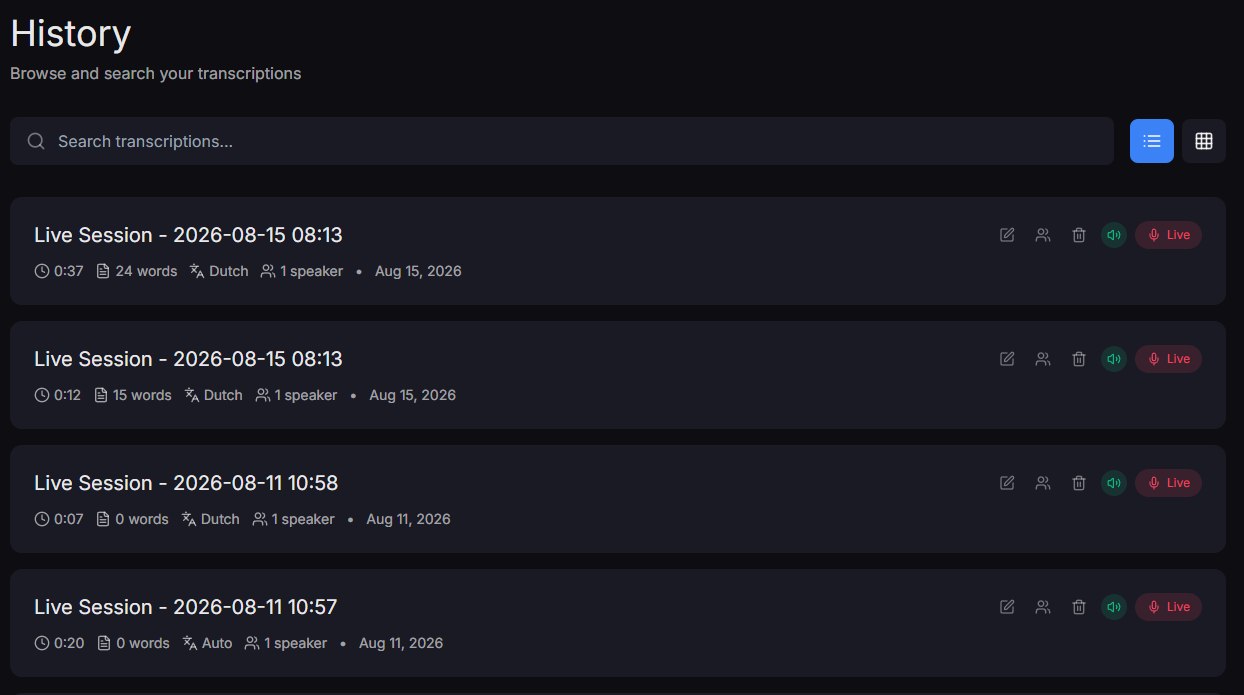
Cronologia consultabile
Ogni sessione salvata, ricercabile ed etichettata per lingua, durata e interlocutori.
Progetto
ScribeDash
Tipo
App web di trascrizione in tempo reale
Tecnologia
React, WebSockets, GPU inference
Anno
2025
Perché ho creato ScribeDash
Come segretario del consiglio direttivo redigevo regolarmente i verbali delle riunioni, quindi so quanto sia prezioso avere l'audio registrato accanto al testo trascritto per verificare, parola per parola, ciò che è stato effettivamente detto. Il problema: la trascrizione integrata in Office 365 era francamente inutilizzabile, e Copilot in Teams mi sfiancava in fretta senza essere di grande aiuto, così ho deciso di costruirmi semplicemente la mia soluzione.
Così ho creato ScribeDash: un'app web di trascrizione online in tempo reale. Collega un microfono, avvia la registrazione e le tue parole compaiono come testo all'istante, con l'etichetta di chi parla così puoi vedere chi ha detto cosa. Puoi anche caricare file audio o video esistenti, oppure far ripassare una registrazione salvata attraverso la pipeline per ritrascriverla.
Tutto gira sulla mia infrastruttura sovereign, che gestisco dall'inizio alla fine. Il testo trascritto degli altri utenti non è mai visibile per me, quindi è un modo davvero privato e sicuro di trattare registrazioni sensibili: pensa a comuni, riunioni riservate e alla registrazione di clienti per verbali fedeli.
Cosa fa
Trascrizione in tempo reale
Parla e vedi il testo comparire nel giro di un secondo, senza attese per caricamenti o elaborazioni in batch.
Riconoscimento di chi parla
Etichette automatiche degli interlocutori (Speaker 1, Speaker 2, ...) così verbali e interviste sono facili da seguire.
GPU inference in proprio
I modelli AI girano sul mio hardware, quindi non c'è alcuna dipendenza da API di trascrizione esterne e nessun dato lascia mai la mia infrastruttura sovereign.
Multilingue
Trascrivi in molte lingue, con un selettore di lingua chiaro così il modello sa esattamente cosa aspettarsi.
Carica audio e video
Non solo dal vivo: carica file audio o video esistenti e ottieni una trascrizione completa, con l'indicazione di chi parla.
Ritrascrivi su richiesta
Fai ripassare una registrazione salvata attraverso la pipeline, ad esempio con una lingua diversa o un modello migliorato, senza registrare nulla di nuovo.
La parte più difficile: multilingue, senza andare alla deriva
La sfida più ardua è stata mettere a punto un modello linguistico AI che gestisse bene più lingue.
Il problema: una volta scelta una lingua, il modello deve rimanervi fedele. Una configurazione ingenua andrebbe alla deriva: una frase in olandese con una sola parola inglese potrebbe improvvisamente ribaltare l'intera trascrizione in un'altra lingua a metà sessione. Per verbali che devono essere fedeli, questo è inaccettabile.
Come l'ho risolto
Blocco esplicito della lingua
La lingua selezionata viene fissata per l'intera sessione e passata al modello a ogni blocco audio, invece di lasciare che la rilevi automaticamente per ogni frammento.
Inferenza in streaming su GPU
L'audio viene trasmesso in streaming alla mia GPU in piccoli blocchi, così i risultati sono quasi istantanei pur rimanendo coerenti con la lingua bloccata.
Post-elaborazione consapevole di chi parla
Le trascrizioni vengono ricucite insieme ed etichettate per interlocutore, così l'output nella lingua bloccata resta pulito e leggibile.
Il risultato: scegli l'olandese e resta olandese, anche con l'occasionale parola inglese, così la trascrizione corrisponde a ciò che è stato davvero detto.
Il risultato in numeri
<1s
Latenza dalla voce al testo
99+
Lingue supportate
100%
Cloud sovereign, nessun accesso da terzi
L'esito
ScribeDash trasforma un compito noioso, scrivere verbali fedeli, in qualcosa che accade dal vivo. Durante una riunione vedi già la trascrizione prendere forma, e in seguito puoi riascoltare l'audio accanto al testo esatto.
Poiché tutto gira sulla mia infrastruttura sovereign e autogestita, e nessuno (nemmeno io) può vedere le trascrizioni degli altri utenti, resta veloce, privata e sicura, anche per i temi più sensibili.
Dal vivo
Il testo compare mentre parli
Fedele
Audio e testo fianco a fianco
Privato
Gira su GPU propria, nessuna API esterna
Sotto il cofano
Vuoi qualcosa di simile?
Dalle app AI in tempo reale ai modelli self-hosted sul tuo hardware: se riesci a immaginarlo, io posso costruirlo.