स्वयं निर्मित SaaS · रियल-टाइम AI
ScribeDash
एक रियल-टाइम स्पीच-टू-टेक्स्ट वेब ऐप जो बोलते ही लाइव ऑडियो को सटीक, वक्ता-लेबल किए गए ट्रांसक्रिप्ट में बदल देता है। माइक्रोफ़ोन प्लग करें, रिकॉर्ड दबाएं, और शब्दों को तुरंत उभरते हुए देखें, जो मेरे अपने GPU inference पर चलने वाले AI द्वारा संचालित हैं।
ScribeDash के भीतर एक नज़र
लैंडिंग पेज से लेकर लाइव रिकॉर्डिंग स्टूडियो तक।
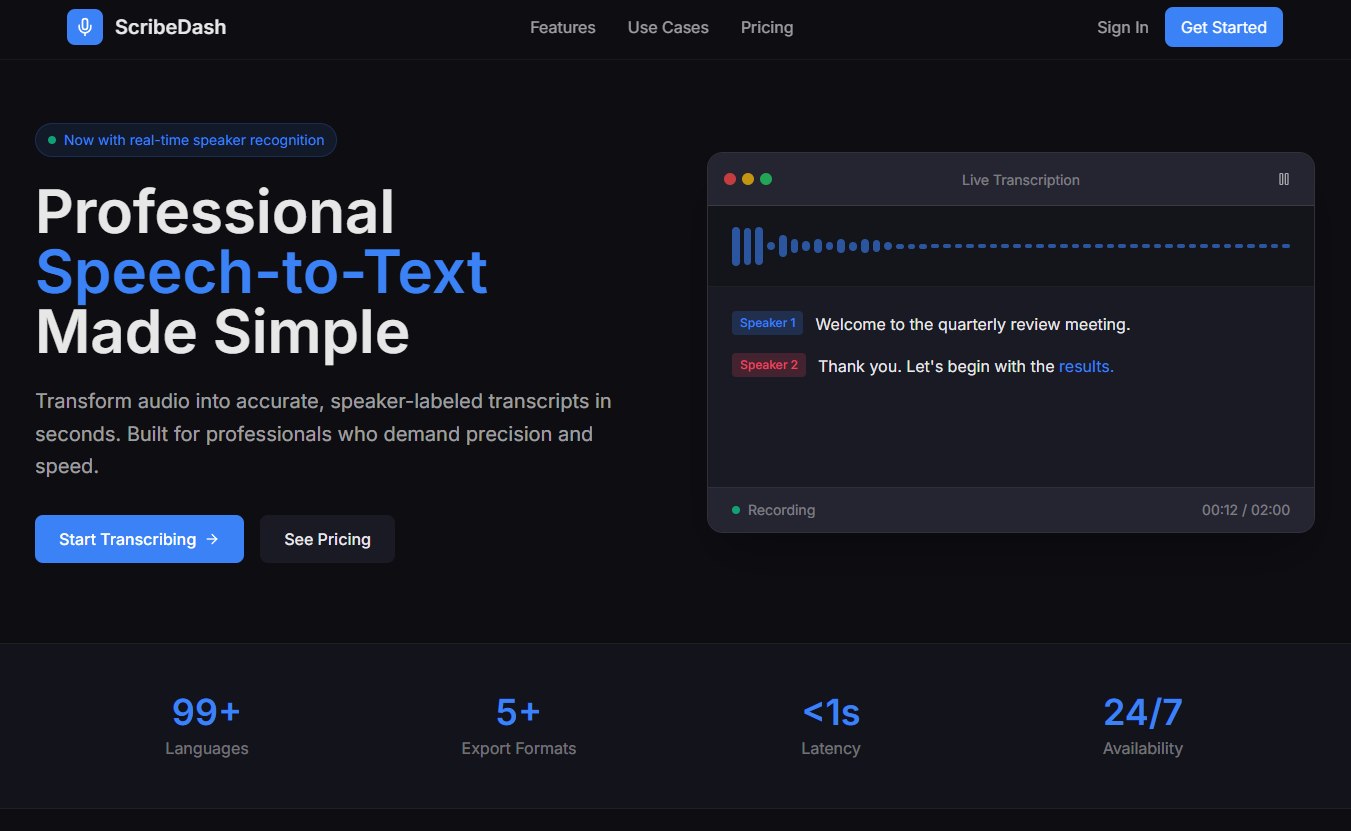
पेशेवर स्पीच-टू-टेक्स्ट
लैंडिंग पेज: सेकंडों में ऑडियो को सटीक, वक्ता-लेबल किए गए ट्रांसक्रिप्ट में बदलें।
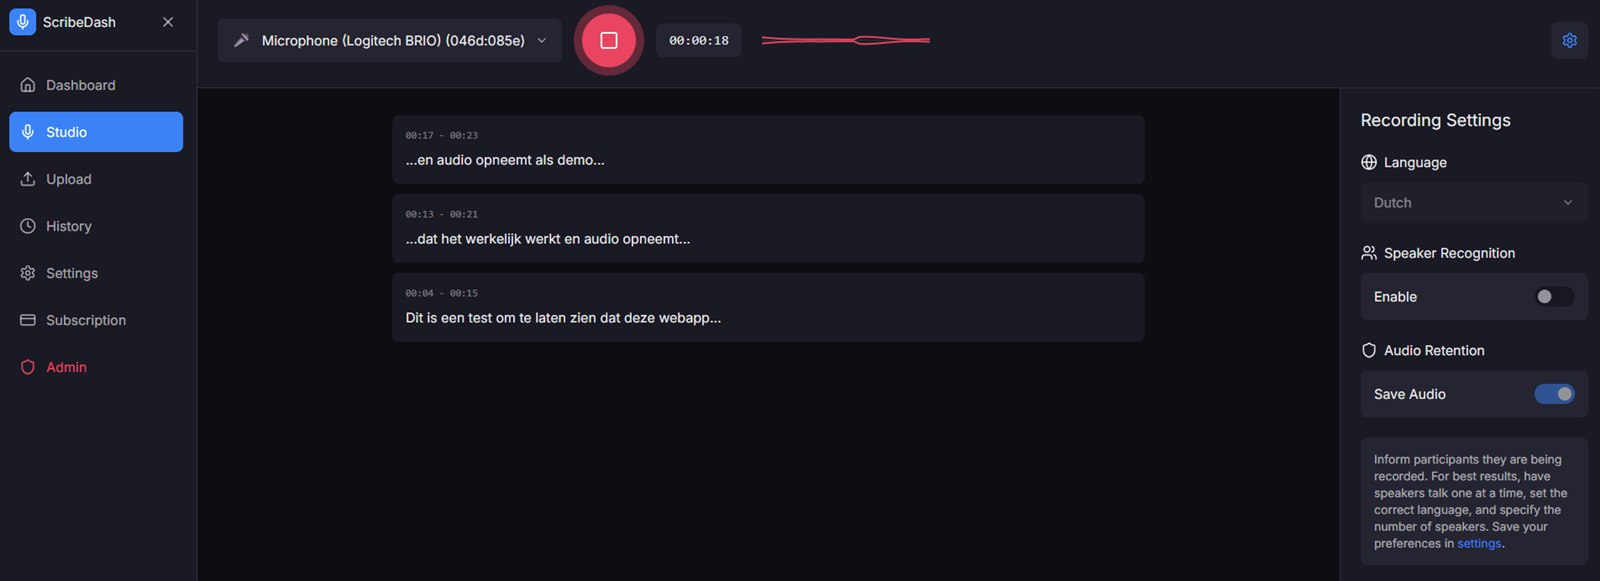
लाइव रिकॉर्डिंग स्टूडियो
किसी भी माइक्रोफ़ोन से रिकॉर्ड करें और ट्रांसक्रिप्ट को रियल-टाइम में स्ट्रीम होते देखें, भाषा और वक्ता-पहचान सेटिंग्स के साथ।
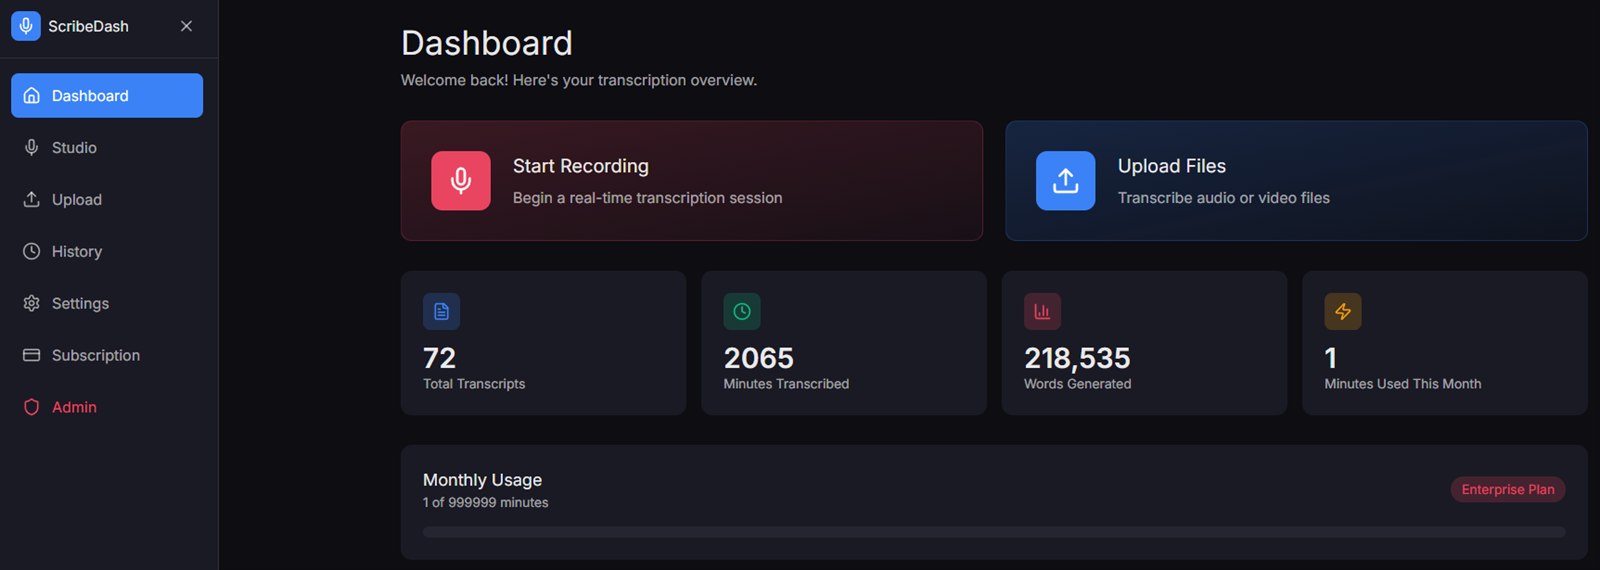
आपका ट्रांसक्रिप्शन डैशबोर्ड
ट्रांसक्रिप्ट, ट्रांसक्राइब किए गए मिनट और उत्पन्न शब्दों का अवलोकन, रिकॉर्ड या अपलोड करने के त्वरित एक्शन के साथ।
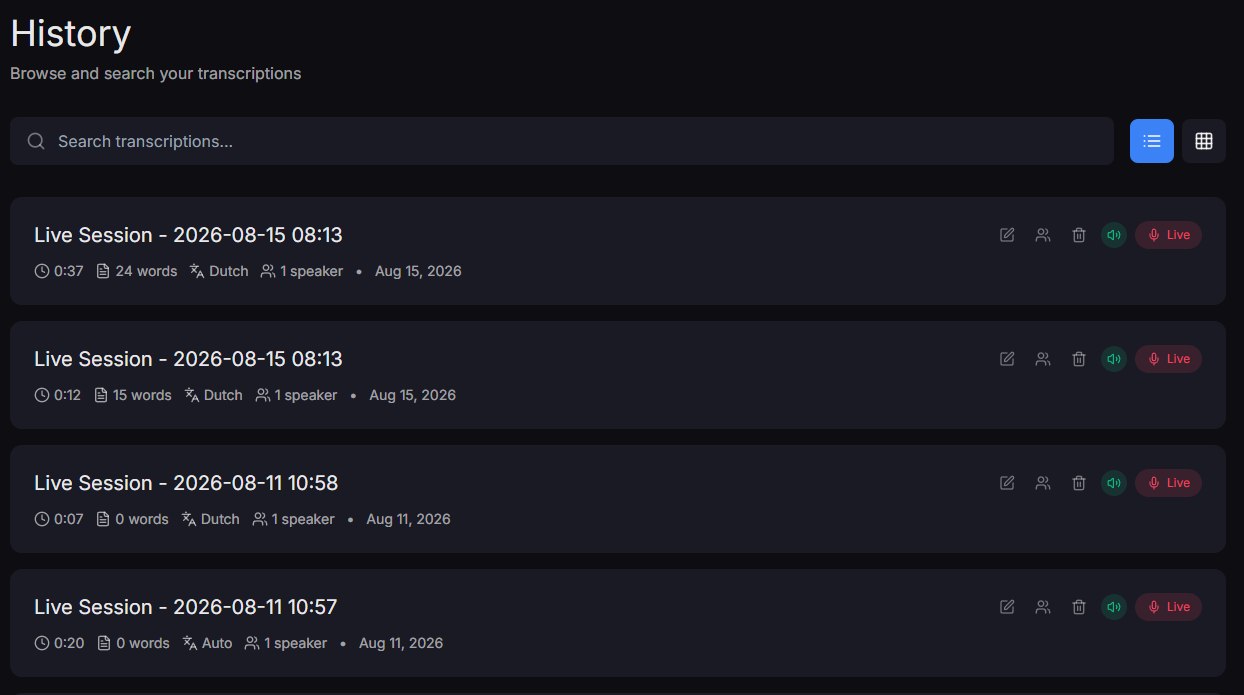
खोजने योग्य इतिहास
हर सत्र सहेजा गया, खोजने योग्य और भाषा, अवधि तथा वक्ताओं के अनुसार लेबल किया गया।
प्रोजेक्ट
ScribeDash
प्रकार
रियल-टाइम ट्रांसक्रिप्शन वेब ऐप
प्रौद्योगिकी
React, WebSockets, GPU inference
वर्ष
2025
मैंने ScribeDash क्यों बनाया
एक बोर्ड सचिव के रूप में मैं नियमित रूप से बैठक के मिनट लिखता था, इसलिए मुझे पता है कि ट्रांसक्राइब किए गए टेक्स्ट के साथ रिकॉर्ड किए गए ऑडियो का होना कितना मूल्यवान है, ताकि शब्द-दर-शब्द यह सत्यापित किया जा सके कि वास्तव में क्या कहा गया था। पेच यह था: Office 365 में बना ट्रांसक्रिप्शन सच कहूं तो अनुपयोगी था, और Teams में Copilot ने बिना ज्यादा मदद किए मुझे जल्दी ही थका दिया, इसलिए मैंने बस अपना खुद का बनाने का फैसला किया।
तो मैंने ScribeDash बनाया: एक ऑनलाइन, रियल-टाइम ट्रांसक्रिप्शन वेब ऐप। एक माइक्रोफ़ोन कनेक्ट करें, रिकॉर्डिंग शुरू करें, और आपके बोले गए शब्द तुरंत टेक्स्ट के रूप में दिखाई देते हैं, वक्ता लेबल के साथ ताकि आप देख सकें कि किसने क्या कहा। आप मौजूदा ऑडियो या वीडियो फ़ाइलें भी अपलोड कर सकते हैं, या किसी सहेजी गई रिकॉर्डिंग को फिर से ट्रांसक्राइब करने के लिए पाइपलाइन के माध्यम से दोबारा चला सकते हैं।
सब कुछ मेरे अपने सॉवरेन इंफ्रास्ट्रक्चर पर चलता है, जिसे मैं आद्योपांत स्वयं प्रबंधित करता हूं। अन्य उपयोगकर्ताओं का ट्रांसक्राइब किया गया टेक्स्ट मुझे कभी दिखाई नहीं देता, इसलिए संवेदनशील रिकॉर्डिंग को संभालने का यह वास्तव में निजी और सुरक्षित तरीका है: जैसे नगरपालिकाएं, गोपनीय बैठकें और शब्दशः मिनट के लिए क्लाइंट्स को रिकॉर्ड करना।
यह क्या करता है
रियल-टाइम ट्रांसक्रिप्शन
बोलें और एक सेकंड के भीतर टेक्स्ट को उभरते देखें, बिना किसी अपलोड या बैच प्रोसेसिंग की प्रतीक्षा के।
वक्ता पहचान
स्वचालित वक्ता लेबल (Speaker 1, Speaker 2, ...) ताकि मिनट और साक्षात्कार आसानी से समझे जा सकें।
अपना GPU inference
AI मॉडल मेरे अपने हार्डवेयर पर चलते हैं, इसलिए बाहरी ट्रांसक्रिप्शन API पर कोई निर्भरता नहीं है और कोई भी डेटा कभी मेरे सॉवरेन इंफ्रास्ट्रक्चर से बाहर नहीं जाता।
बहुभाषी
कई भाषाओं में ट्रांसक्राइब करें, एक स्पष्ट भाषा चयनकर्ता के साथ ताकि मॉडल को ठीक-ठीक पता हो कि क्या अपेक्षित है।
ऑडियो और वीडियो अपलोड करें
केवल लाइव ही नहीं: मौजूदा ऑडियो या वीडियो फ़ाइलें डालें और पूरा, वक्ता-लेबल किया गया ट्रांसक्रिप्ट वापस पाएं।
मांग पर फिर से ट्रांसक्राइब करें
किसी सहेजी गई रिकॉर्डिंग को पाइपलाइन के माध्यम से दोबारा चलाएं, उदाहरण के लिए किसी भिन्न भाषा या बेहतर मॉडल के साथ, बिना कुछ नया रिकॉर्ड किए।
सबसे कठिन हिस्सा: बहुभाषी, बिना भटके
सबसे कठिन चुनौती एक ऐसे AI भाषा मॉडल को जोड़ना था जो कई भाषाओं को अच्छी तरह संभाले।
पेच यह था: एक बार जब आप कोई भाषा चुन लेते हैं, तो मॉडल को उसी पर टिके रहना होता है। एक भोला-भाला सेटअप भटक जाएगा, एक अंग्रेज़ी शब्द वाला डच वाक्य अचानक पूरे ट्रांसक्रिप्शन को सत्र के बीच में ही किसी दूसरी भाषा में बदल सकता है। ऐसे मिनट के लिए जिन्हें शब्दशः होना चाहिए, यह अस्वीकार्य है।
मैंने इसे कैसे हल किया
स्पष्ट भाषा लॉकिंग
चुनी गई भाषा पूरे सत्र के लिए स्थिर कर दी जाती है और हर ऑडियो खंड पर मॉडल को दी जाती है, बजाय इसके कि उसे हर टुकड़े के लिए स्वतः पहचान करने दिया जाए।
GPU पर स्ट्रीमिंग inference
ऑडियो को छोटे-छोटे खंडों में मेरे अपने GPU पर स्ट्रीम किया जाता है, इसलिए परिणाम लगभग तत्काल मिलते हैं और साथ ही लॉक की गई भाषा के अनुरूप बने रहते हैं।
वक्ता-सचेत पोस्ट-प्रोसेसिंग
ट्रांसक्रिप्ट को एक साथ जोड़ा जाता है और प्रति वक्ता लेबल किया जाता है, ताकि लॉक-भाषा का आउटपुट स्वच्छ और पठनीय बना रहे।
परिणाम: डच चुनें और यह डच ही रहती है, कभी-कभार आने वाले अंग्रेज़ी शब्द के बावजूद, ताकि ट्रांसक्रिप्ट उससे मेल खाए जो वास्तव में कहा गया था।
संख्याओं में परिणाम
<1s
बोलने से टेक्स्ट तक की विलंबता
99+
समर्थित भाषाएं
100%
सॉवरेन क्लाउड, कोई तृतीय-पक्ष पहुंच नहीं
परिणाम
ScribeDash एक थकाऊ काम, शब्दशः मिनट लिखना, को ऐसी चीज़ में बदल देता है जो लाइव होती है। किसी बैठक के दौरान ही आप ट्रांसक्रिप्ट को बनते देखते हैं, और बाद में आप ठीक उसी टेक्स्ट के साथ ऑडियो फिर से चला सकते हैं।
क्योंकि सब कुछ मेरे अपने सॉवरेन, स्वयं-प्रबंधित इंफ्रास्ट्रक्चर पर चलता है, और कोई भी (मैं तक नहीं) अन्य उपयोगकर्ताओं के ट्रांसक्रिप्ट नहीं देख सकता, यह तेज़, निजी और सुरक्षित बना रहता है, यहां तक कि सबसे संवेदनशील विषयों के लिए भी।
लाइव
बोलते ही टेक्स्ट दिखाई देता है
शब्दशः
ऑडियो और टेक्स्ट साथ-साथ
निजी
अपने GPU पर चलता है, कोई बाहरी API नहीं
पर्दे के पीछे
ऐसा कुछ चाहिए?
रियल-टाइम AI ऐप्स से लेकर आपके अपने हार्डवेयर पर self-hosted मॉडल तक: अगर आप इसे सोच सकते हैं, तो मैं इसे बना सकता हूं।