SaaS développé en interne · IA en temps réel
ScribeDash
Une application web de reconnaissance vocale en temps réel qui transforme l'audio en direct en transcriptions précises et attribuées à chaque intervenant, au fil de votre parole. Branchez un microphone, lancez l'enregistrement et regardez les mots apparaître instantanément, propulsés par une IA tournant sur ma propre inférence GPU.
Un aperçu de ScribeDash
De la page d'accueil au studio d'enregistrement en direct.
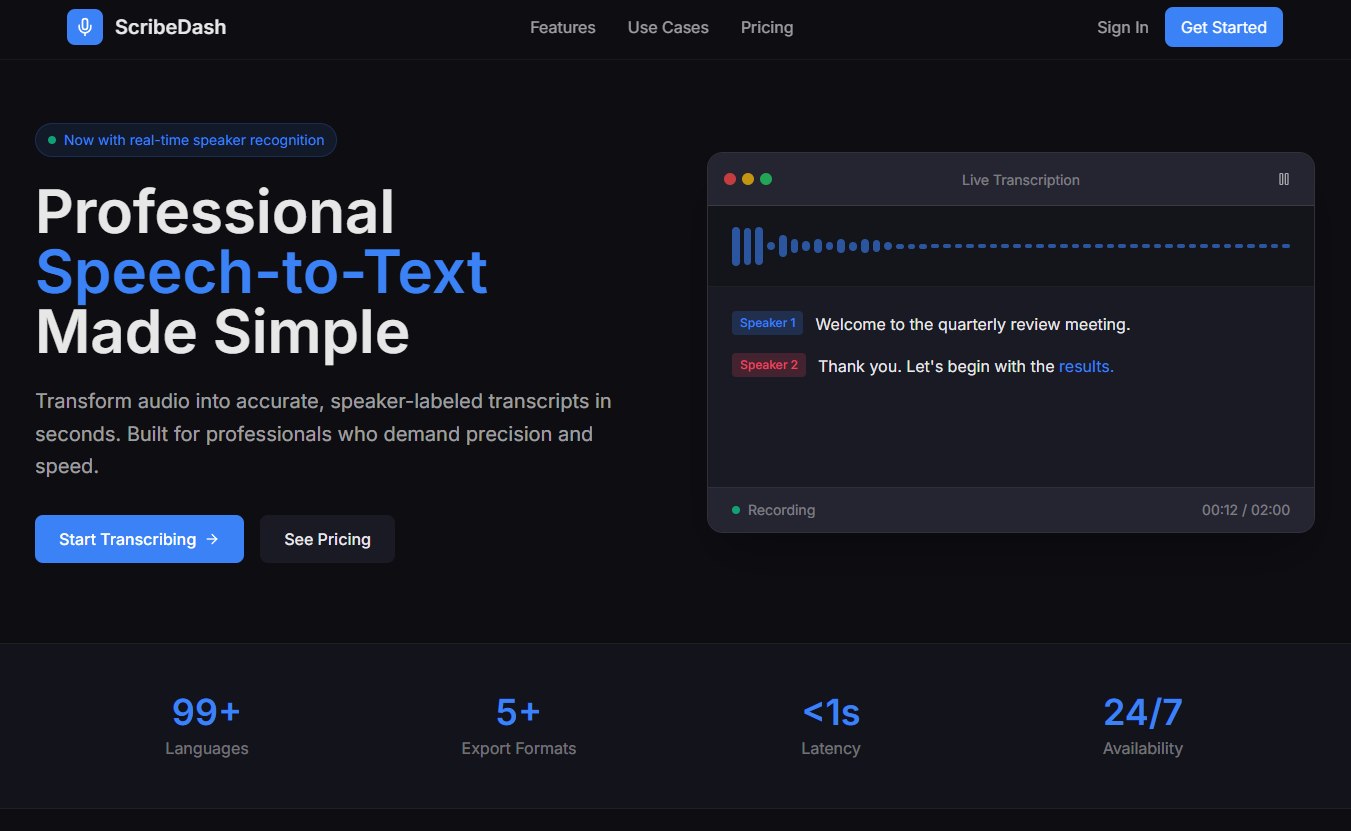
Reconnaissance vocale professionnelle
La page d'accueil : transformez l'audio en transcriptions précises et attribuées à chaque intervenant en quelques secondes.
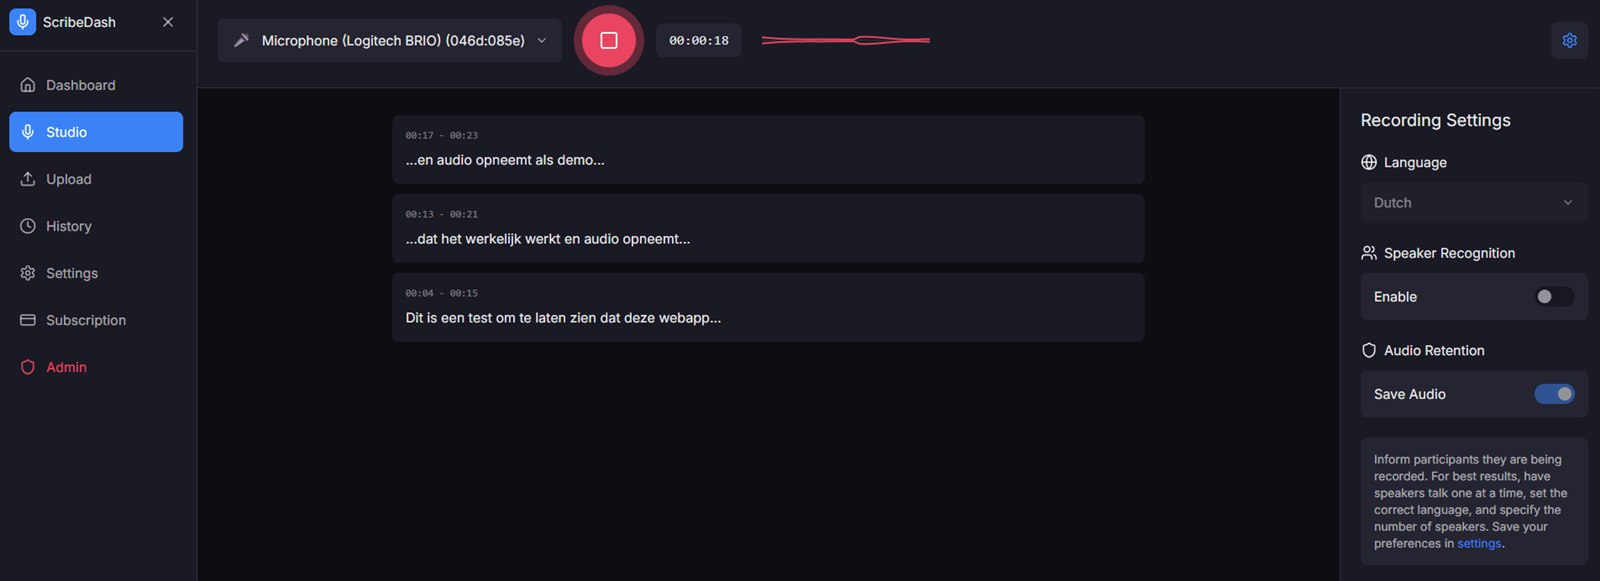
Studio d'enregistrement en direct
Enregistrez depuis n'importe quel microphone et voyez la transcription défiler en temps réel, avec des réglages de langue et de reconnaissance des intervenants.
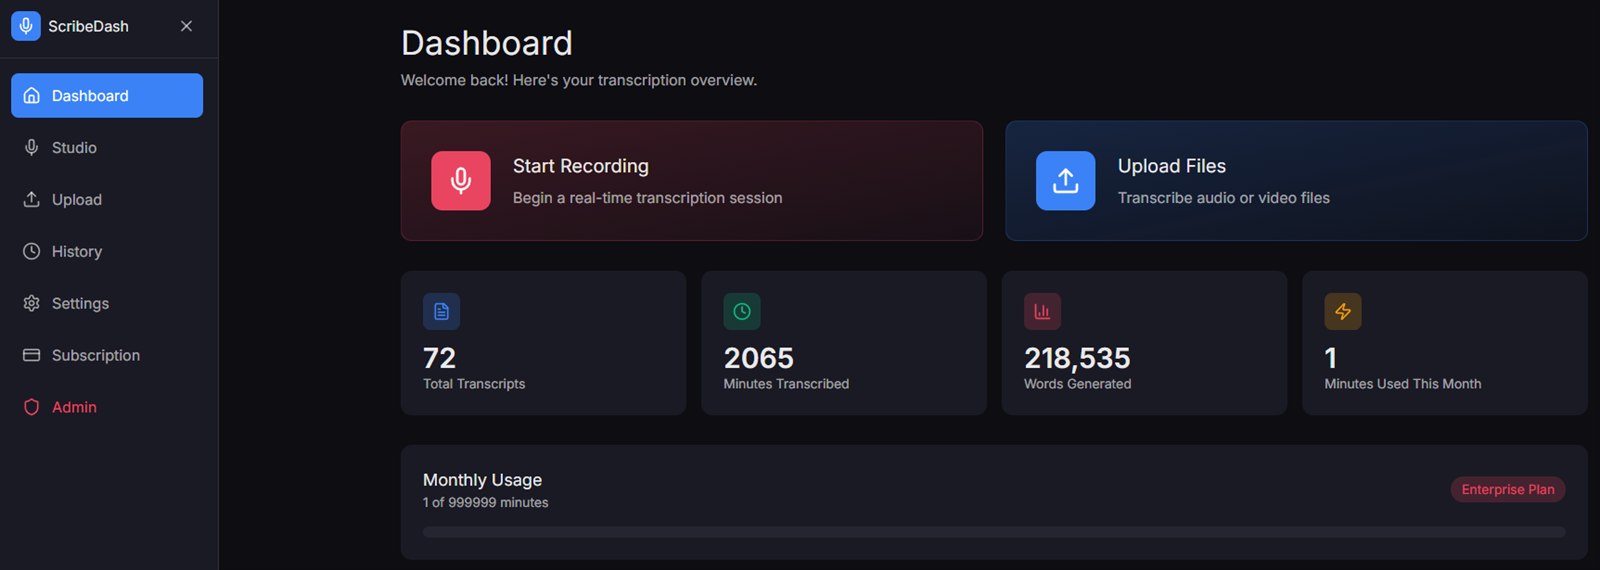
Votre tableau de bord de transcription
Une vue d'ensemble des transcriptions, des minutes transcrites et des mots générés, avec des actions rapides pour enregistrer ou importer.
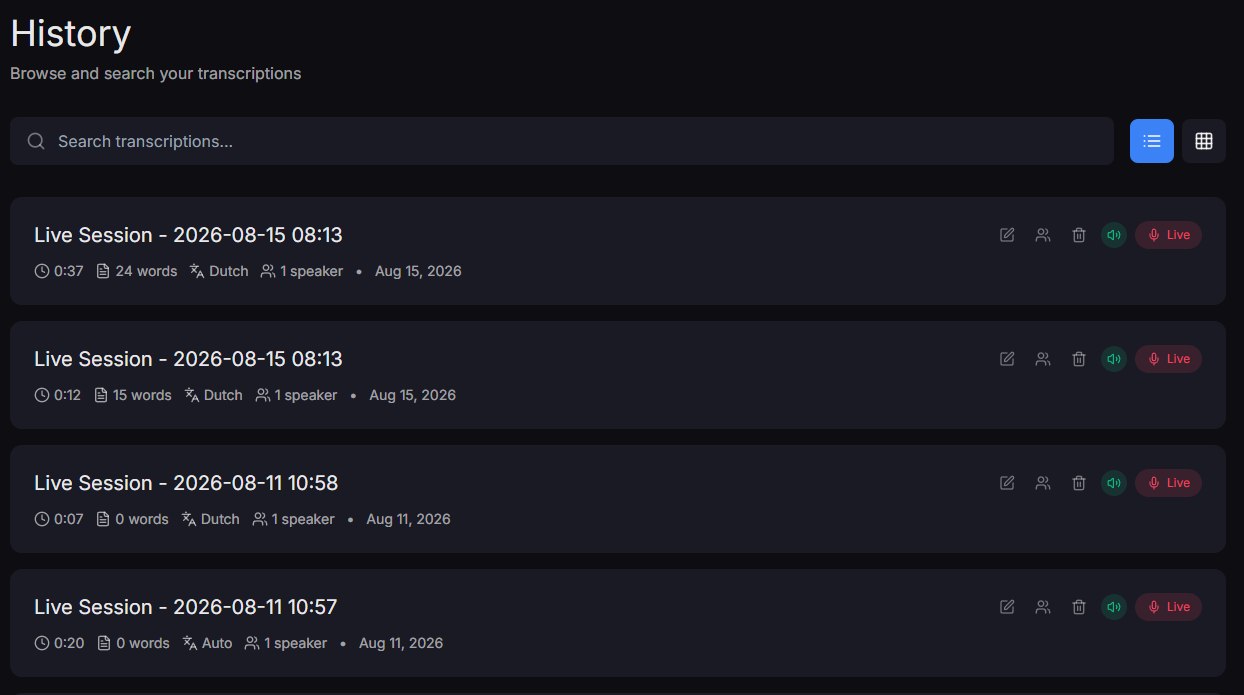
Historique consultable
Chaque session est sauvegardée, consultable et étiquetée par langue, durée et intervenants.
Projet
ScribeDash
Type
Application web de transcription en temps réel
Technologie
React, WebSockets, GPU inference
Année
2025
Pourquoi j'ai créé ScribeDash
En tant que secrétaire de conseil, je rédigeais régulièrement des comptes rendus de réunion, je sais donc à quel point il est précieux d'avoir l'audio enregistré à côté du texte transcrit pour vérifier, mot pour mot, ce qui a réellement été dit. Le problème : la transcription intégrée à Office 365 était franchement inutilisable, et Copilot dans Teams m'a vite épuisé sans être d'une grande aide, alors j'ai décidé de créer ma propre solution.
J'ai donc créé ScribeDash : une application web de transcription en ligne et en temps réel. Connectez un microphone, lancez l'enregistrement et vos paroles apparaissent instantanément sous forme de texte, avec l'attribution des intervenants pour voir qui a dit quoi. Vous pouvez aussi importer des fichiers audio ou vidéo existants, ou repasser un enregistrement sauvegardé dans le pipeline pour le retranscrire.
Tout fonctionne sur ma propre infrastructure souveraine, que je gère de bout en bout. Le texte transcrit des autres utilisateurs ne m'est jamais visible : c'est donc une manière véritablement privée et sûre de traiter des enregistrements sensibles : pensez aux municipalités, aux réunions confidentielles et à l'enregistrement de clients pour des comptes rendus intégraux.
Ce qu'elle fait
Transcription en temps réel
Parlez et voyez le texte apparaître en moins d'une seconde, sans attendre d'import ni de traitement par lots.
Reconnaissance des intervenants
Attribution automatique des intervenants (Speaker 1, Speaker 2, ...) pour suivre facilement comptes rendus et entretiens.
Inférence GPU personnelle
Les modèles d'IA tournent sur mon propre matériel : aucune dépendance à des API de transcription externes et aucune donnée ne quitte jamais mon infrastructure souveraine.
Multilingue
Transcrivez dans de nombreuses langues, avec un sélecteur de langue clair pour que le modèle sache exactement à quoi s'attendre.
Import audio et vidéo
Pas seulement en direct : déposez des fichiers audio ou vidéo existants et récupérez une transcription complète, attribuée à chaque intervenant.
Retranscription à la demande
Repassez un enregistrement sauvegardé dans le pipeline, par exemple avec une autre langue ou un modèle amélioré, sans rien enregistrer de nouveau.
Le plus difficile : le multilingue, sans dérive
Le défi le plus ardu a été de mettre en place un modèle de langage IA qui gère bien plusieurs langues.
Le problème : une fois une langue choisie, le modèle doit s'y tenir. Une configuration naïve dériverait, une phrase en néerlandais contenant un seul mot anglais pourrait soudain faire basculer toute la transcription vers une autre langue en pleine session. Pour des comptes rendus qui doivent être intégraux, c'est inacceptable.
Comment je l'ai résolu
Verrouillage explicite de la langue
La langue sélectionnée est fixée pour toute la session et transmise au modèle à chaque segment audio, au lieu de le laisser détecter automatiquement à chaque fragment.
Inférence en streaming sur GPU
L'audio est diffusé vers mon propre GPU en petits segments, pour des résultats quasi instantanés tout en restant cohérents avec la langue verrouillée.
Post-traitement tenant compte des intervenants
Les transcriptions sont assemblées et attribuées à chaque intervenant, pour que le résultat en langue verrouillée reste propre et lisible.
Le résultat : choisissez le néerlandais et il reste le néerlandais, même avec un mot anglais occasionnel, pour que la transcription corresponde à ce qui a vraiment été dit.
Le résultat en chiffres
<1s
Latence de la parole au texte
99+
Langues prises en charge
100%
Cloud souverain, aucun accès tiers
Le résultat
ScribeDash transforme une tâche fastidieuse, la rédaction de comptes rendus intégraux, en quelque chose qui se fait en direct. Pendant une réunion, vous voyez déjà la transcription se construire, et ensuite vous pouvez réécouter l'audio à côté du texte exact.
Comme tout fonctionne sur ma propre infrastructure souveraine et autogérée, et que personne (pas même moi) ne peut voir les transcriptions des autres utilisateurs, cela reste rapide, privé et sûr, même pour les sujets les plus sensibles.
En direct
Le texte apparaît pendant que vous parlez
Intégral
L'audio et le texte côte à côte
Privé
Tourne sur un GPU personnel, sans API externe
Sous le capot
Vous voulez quelque chose de ce genre ?
Des applications d'IA en temps réel aux modèles self-hosted sur votre propre matériel : si vous pouvez l'imaginer, je peux le construire.