SaaS propio · IA en tiempo real
ScribeDash
Una aplicación web de voz a texto en tiempo real que convierte el audio en directo en transcripciones precisas y etiquetadas por hablante mientras hablas. Conecta un micrófono, pulsa grabar y observa cómo las palabras aparecen al instante, gracias a la IA que se ejecuta sobre mi propia GPU inference.
Una mirada al interior de ScribeDash
Desde la página de inicio hasta el estudio de grabación en directo.
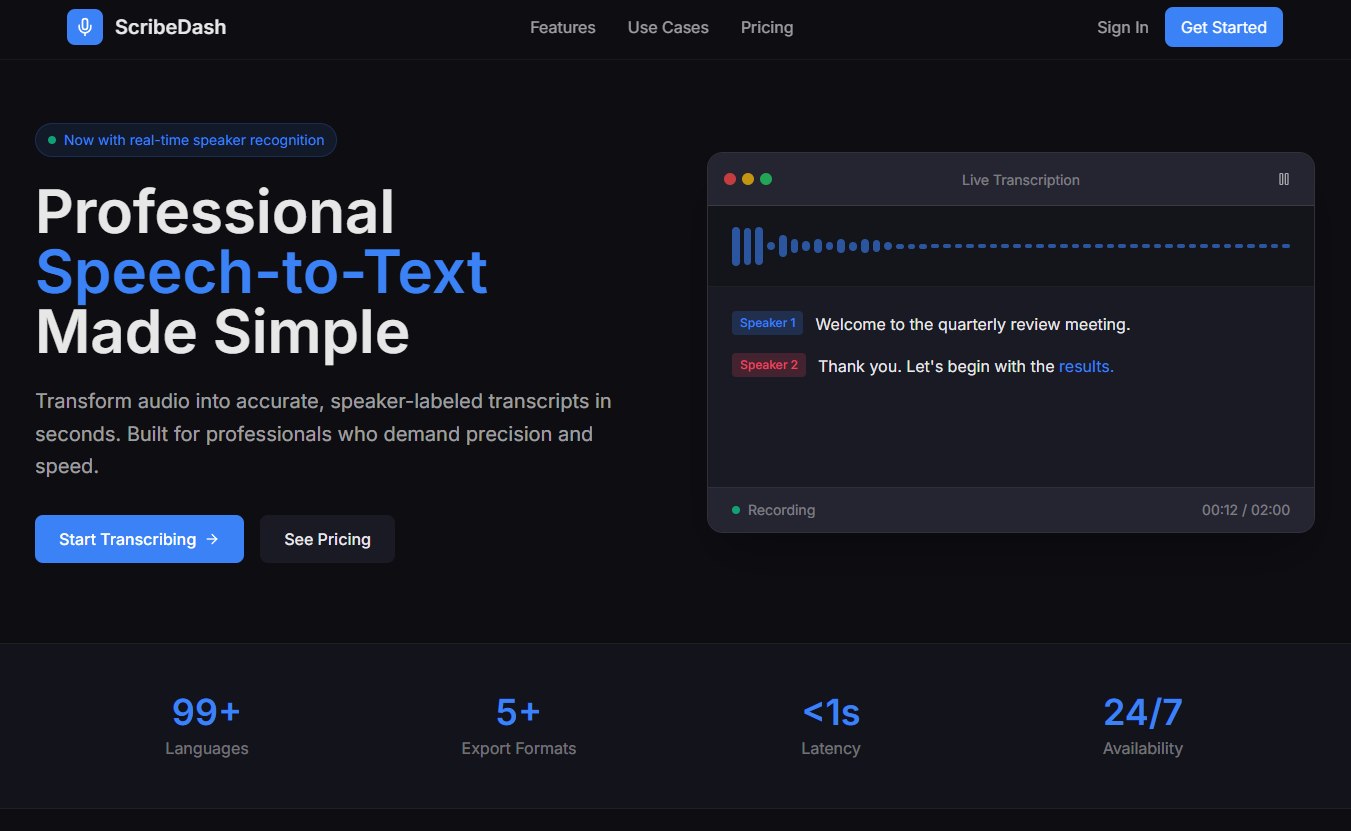
Voz a texto profesional
La página de inicio: convierte el audio en transcripciones precisas y etiquetadas por hablante en segundos.
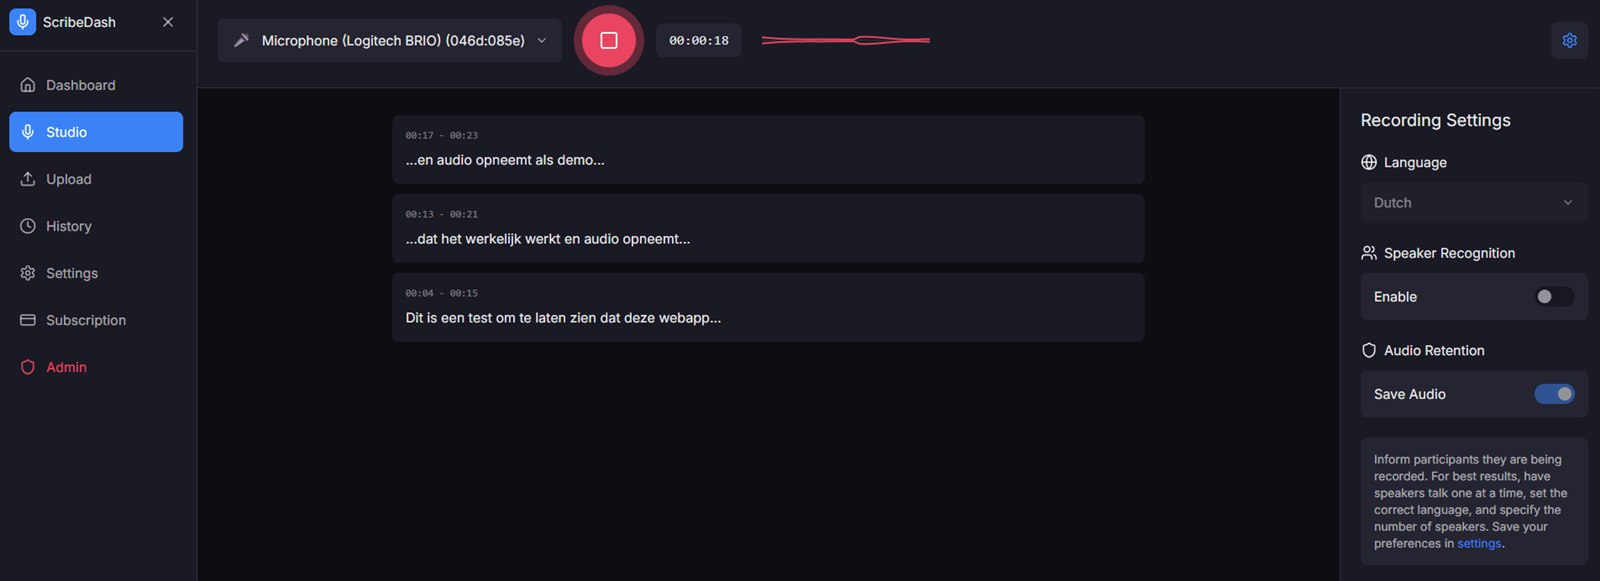
Estudio de grabación en directo
Graba desde cualquier micrófono y observa cómo la transcripción fluye en tiempo real, con ajustes de idioma y de reconocimiento de hablantes.
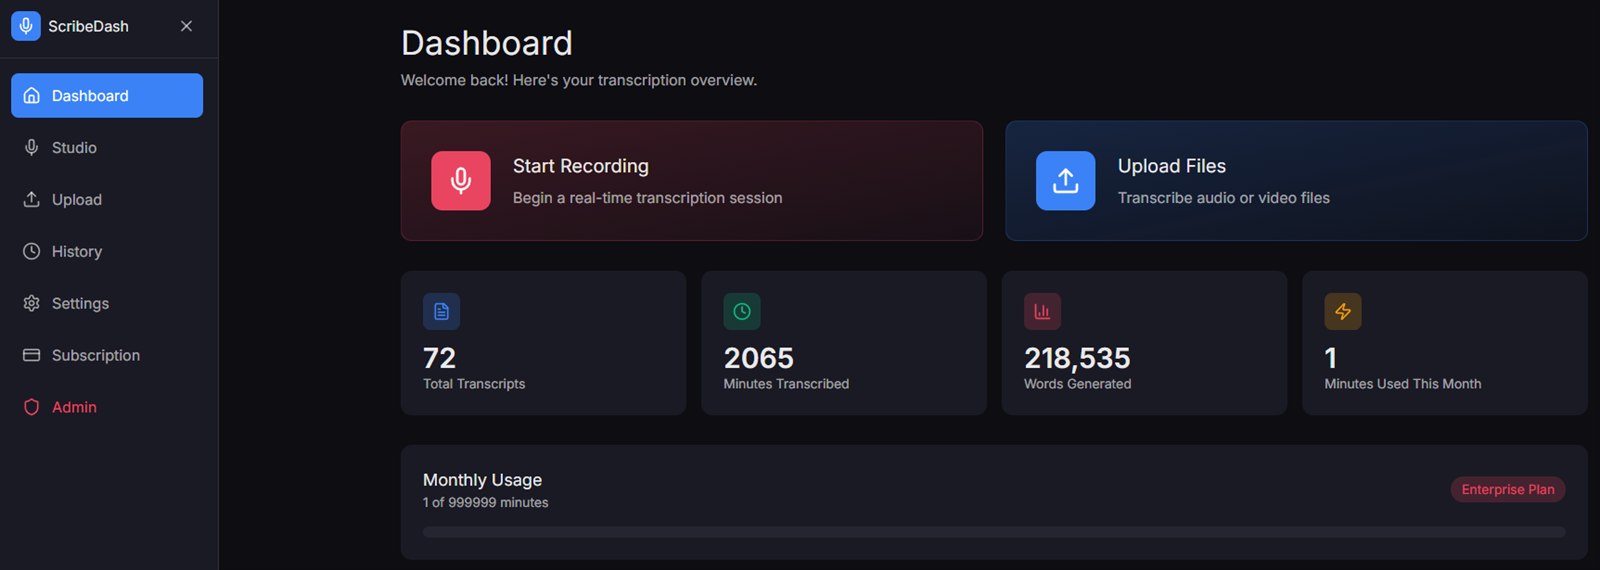
Tu panel de transcripción
Un resumen de las transcripciones, los minutos transcritos y las palabras generadas, con acciones rápidas para grabar o subir archivos.
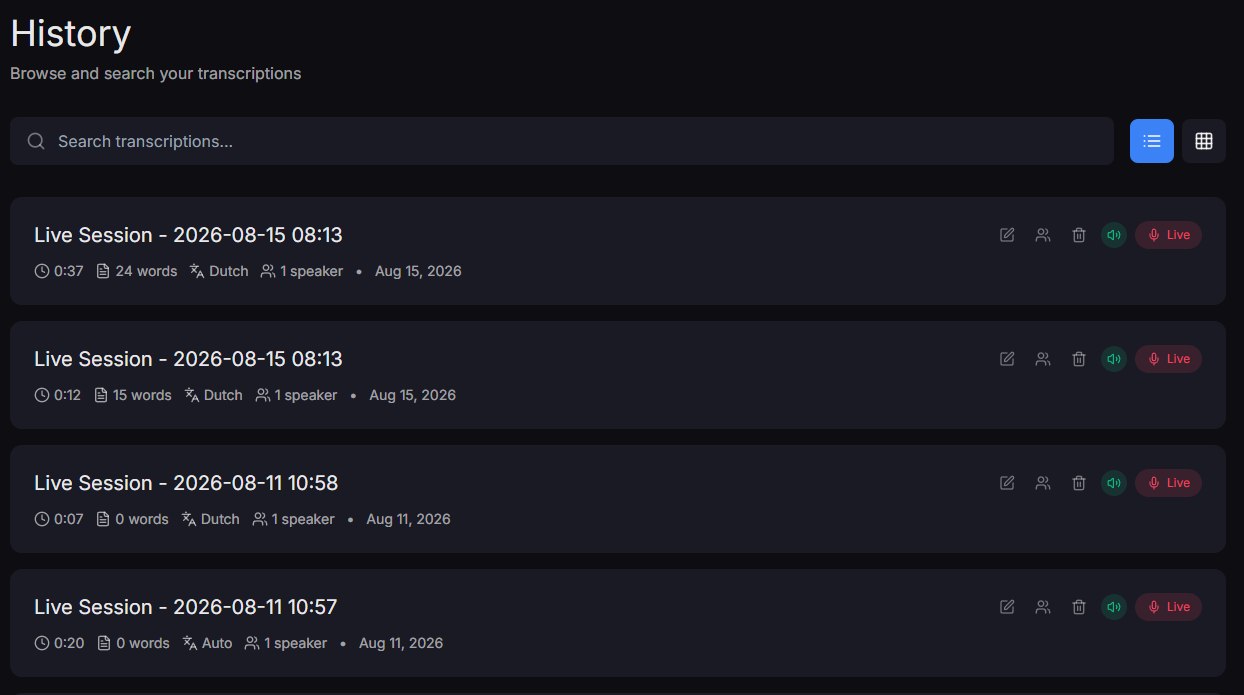
Historial con búsqueda
Cada sesión queda guardada, es fácil de buscar y viene etiquetada por idioma, duración y hablantes.
Proyecto
ScribeDash
Tipo
Aplicación web de transcripción en tiempo real
Tecnología
React, WebSockets, GPU inference
Año
2025
Por qué construí ScribeDash
Como secretario de junta redactaba con frecuencia las actas de las reuniones, así que sé lo valioso que es tener el audio grabado junto al texto transcrito para verificar, palabra por palabra, lo que realmente se dijo. El problema: la transcripción integrada en Office 365 era, sinceramente, inservible, y Copilot en Teams me agotaba rápido sin ser de mucha ayuda, así que decidí construir la mía propia.
Así que construí ScribeDash: una aplicación web de transcripción en línea y en tiempo real. Conecta un micrófono, empieza a grabar y tus palabras aparecen como texto al instante, con etiquetas de hablante para que veas quién dijo qué. También puedes subir archivos de audio o vídeo ya existentes, o volver a pasar una grabación guardada por el pipeline para transcribirla de nuevo.
Todo se ejecuta sobre mi propia infraestructura soberana, que gestiono de principio a fin. El texto transcrito de otros usuarios nunca es visible para mí, por lo que es una forma realmente privada y segura de manejar grabaciones sensibles: piensa en ayuntamientos, reuniones confidenciales y clientes que graban para obtener actas literales.
Qué hace
Transcripción en tiempo real
Habla y ve aparecer el texto en menos de un segundo, sin esperas por subidas ni por procesamiento por lotes.
Reconocimiento de hablantes
Etiquetas de hablante automáticas (Speaker 1, Speaker 2, ...) para que las actas y las entrevistas sean fáciles de seguir.
GPU inference propia
Los modelos de IA se ejecutan sobre mi propio hardware, así que no hay dependencia de APIs de transcripción externas y ningún dato sale nunca de mi infraestructura soberana.
Multilingüe
Transcribe en muchos idiomas, con un selector de idioma claro para que el modelo sepa exactamente qué esperar.
Sube audio y vídeo
No solo en directo: arrastra archivos de audio o vídeo ya existentes y recibe una transcripción completa, etiquetada por hablante.
Retranscribe cuando quieras
Vuelve a pasar una grabación guardada por el pipeline, por ejemplo con otro idioma o un modelo mejorado, sin grabar nada nuevo.
Lo más difícil: multilingüe, sin desviarse
El mayor reto fue integrar un modelo de lenguaje de IA que manejara bien varios idiomas.
El problema: una vez que eliges un idioma, el modelo tiene que ceñirse a él. Una configuración ingenua se desviaría; una frase en neerlandés con una sola palabra en inglés podría, de repente, cambiar toda la transcripción a otro idioma a mitad de la sesión. Para unas actas que deben ser literales, eso es inaceptable.
Cómo lo resolví
Bloqueo explícito del idioma
El idioma seleccionado queda fijado durante toda la sesión y se pasa al modelo en cada fragmento de audio, en lugar de dejar que lo detecte automáticamente por fragmento.
Inferencia en streaming sobre GPU
El audio se transmite a mi propia GPU en pequeños fragmentos, de modo que los resultados son casi instantáneos y se mantienen coherentes con el idioma bloqueado.
Posprocesamiento consciente del hablante
Las transcripciones se cosen entre sí y se etiquetan por hablante, de modo que el resultado en el idioma bloqueado se mantiene limpio y legible.
El resultado: eliges neerlandés y sigue siendo neerlandés, incluso con alguna palabra suelta en inglés, de modo que la transcripción coincide con lo que realmente se dijo.
El resultado en cifras
<1s
Latencia de voz a texto
99+
Idiomas admitidos
100%
Nube soberana, sin acceso de terceros
El desenlace
ScribeDash convierte una tarea tediosa, redactar actas literales, en algo que ocurre en directo. Durante una reunión ya ves cómo se va formando la transcripción y, después, puedes reproducir el audio junto al texto exacto.
Como todo se ejecuta sobre mi propia infraestructura soberana y autogestionada, y nadie (ni siquiera yo) puede ver las transcripciones de otros usuarios, se mantiene rápida, privada y segura, incluso para los temas más sensibles.
En directo
El texto aparece mientras hablas
Literal
Audio y texto lado a lado
Privado
Se ejecuta sobre GPU propia, sin API externa
Por dentro
¿Quieres algo así?
Desde aplicaciones de IA en tiempo real hasta modelos self-hosted sobre tu propio hardware: si puedes imaginarlo, puedo construirlo.