Selbst entwickeltes SaaS · Echtzeit-KI
ScribeDash
Eine Echtzeit-Web-App zur Sprache-zu-Text-Umwandlung, die live gesprochenes Audio direkt in präzise, nach Sprechern gekennzeichnete Transkripte verwandelt, während Sie sprechen. Mikrofon anschließen, Aufnahme starten und zusehen, wie die Wörter sofort erscheinen, angetrieben von KI, die auf meiner eigenen GPU inference läuft.
Ein Blick in ScribeDash
Von der Landingpage bis zum Live-Aufnahmestudio.
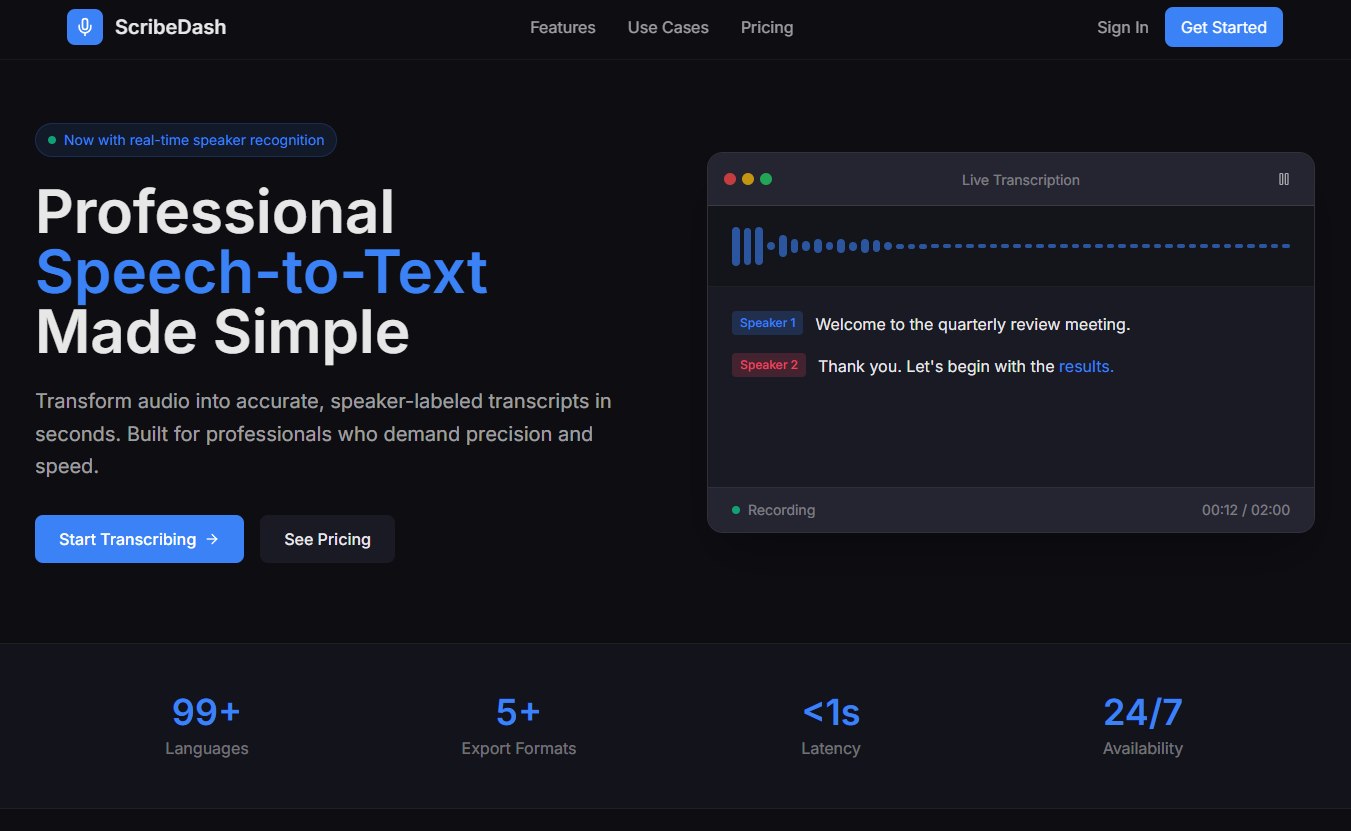
Professionelle Sprache-zu-Text-Umwandlung
Die Landingpage: Verwandeln Sie Audio in Sekunden in präzise, nach Sprechern gekennzeichnete Transkripte.
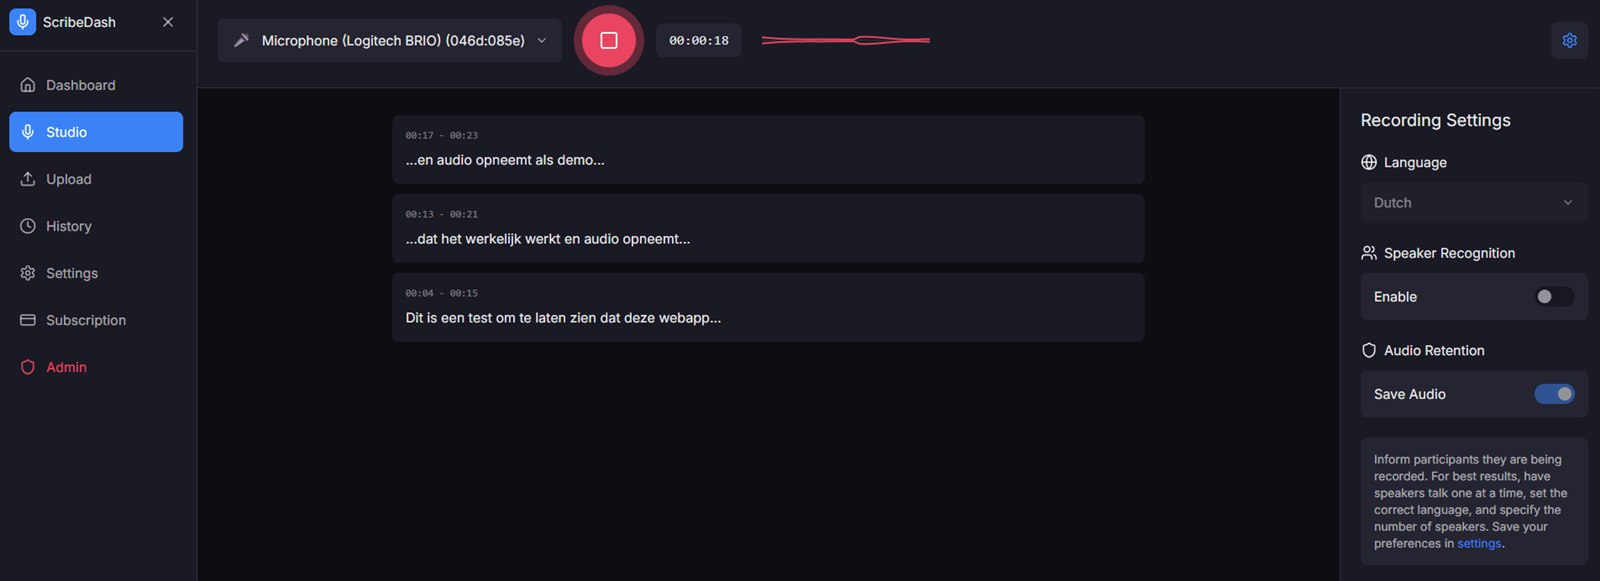
Live-Aufnahmestudio
Nehmen Sie mit jedem beliebigen Mikrofon auf und sehen Sie zu, wie das Transkript in Echtzeit einläuft, mit Einstellungen für Sprache und Sprechererkennung.
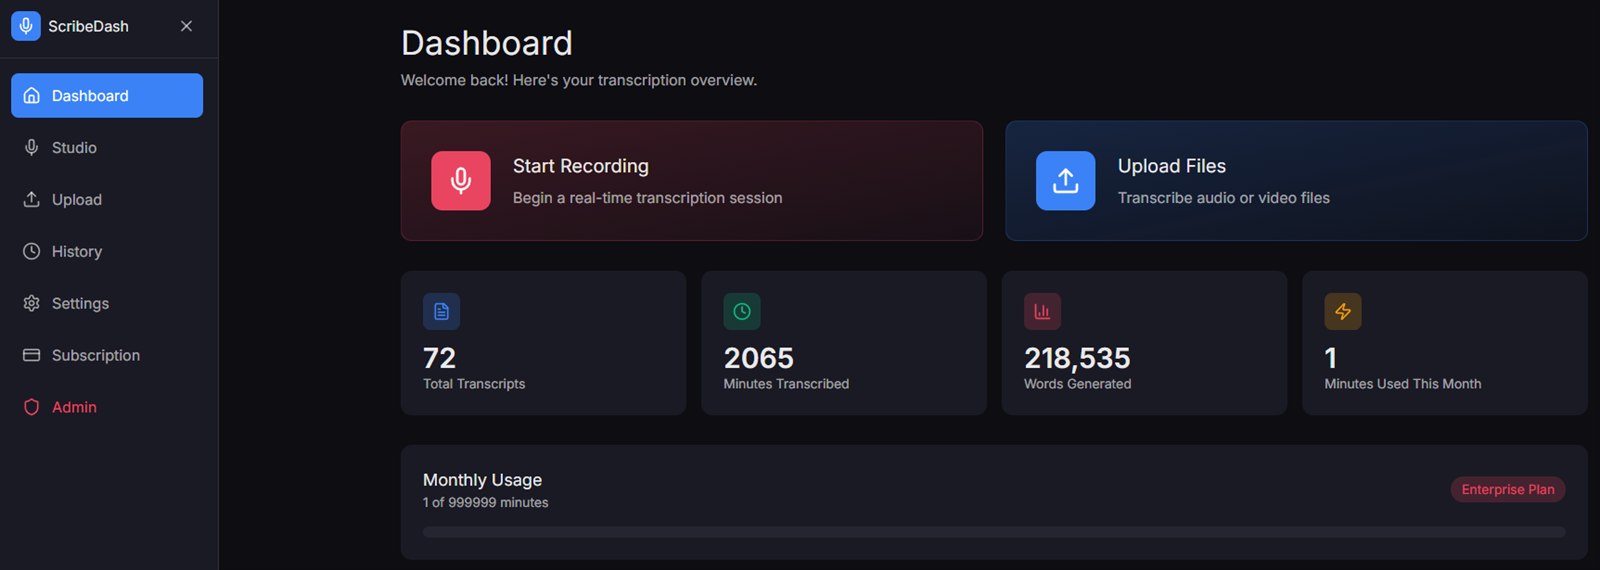
Ihr Transkriptions-Dashboard
Ein Überblick über Transkripte, transkribierte Minuten und generierte Wörter, mit Schnellaktionen zum Aufnehmen oder Hochladen.
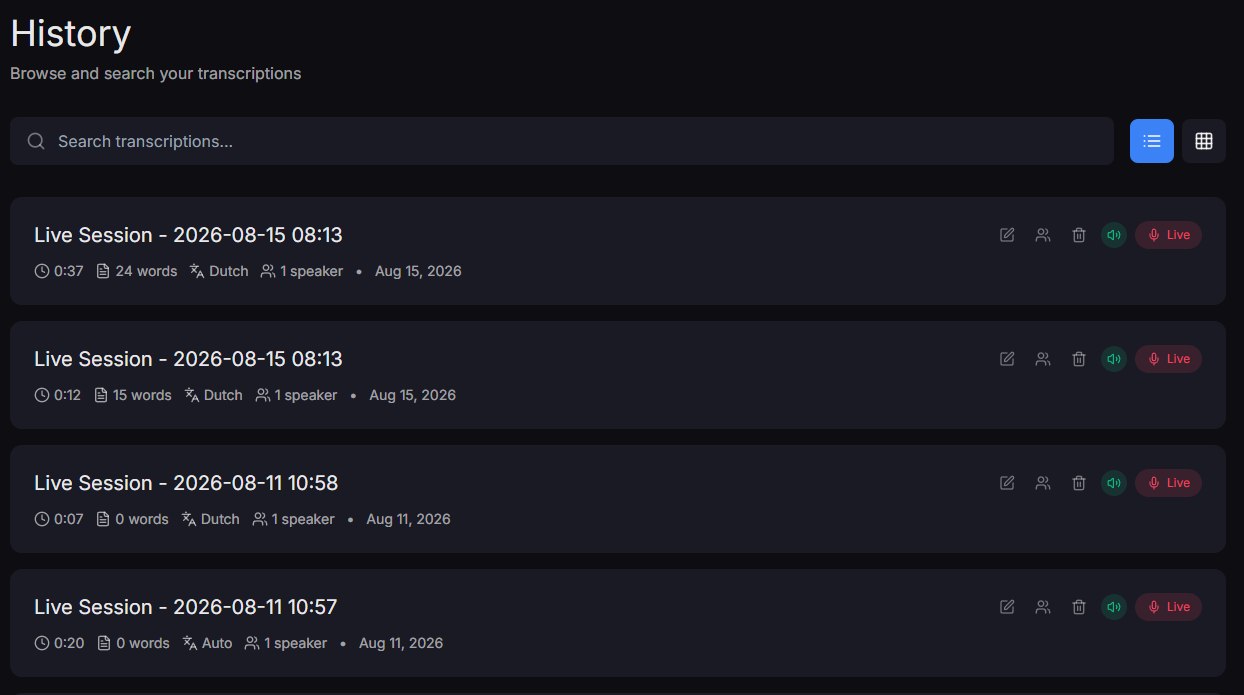
Durchsuchbarer Verlauf
Jede Sitzung gespeichert, durchsuchbar und gekennzeichnet nach Sprache, Dauer und Sprechern.
Projekt
ScribeDash
Typ
Echtzeit-Transkriptions-Web-App
Technologie
React, WebSockets, GPU inference
Jahr
2025
Warum ich ScribeDash entwickelt habe
Als Vorstandssekretär habe ich regelmäßig Sitzungsprotokolle verfasst, deshalb weiß ich, wie wertvoll es ist, das aufgenommene Audio neben dem transkribierten Text zu haben, um Wort für Wort zu überprüfen, was tatsächlich gesagt wurde. Der Haken: Die in Office 365 integrierte Transkription war ehrlich gesagt unbrauchbar, und Copilot in Teams hat mich schnell ermüdet, ohne wirklich zu helfen, also habe ich beschlossen, einfach meine eigene Lösung zu bauen.
So entstand ScribeDash: eine Online-Web-App für Transkription in Echtzeit. Mikrofon anschließen, Aufnahme starten, und Ihre gesprochenen Wörter erscheinen sofort als Text, mit Sprecherkennzeichnungen, damit Sie sehen, wer was gesagt hat. Sie können auch bestehende Audio- oder Videodateien hochladen oder eine gespeicherte Aufnahme erneut durch die Pipeline laufen lassen, um sie neu zu transkribieren.
Alles läuft auf meiner eigenen sovereign Infrastruktur, die ich von A bis Z verwalte. Der transkribierte Text anderer Nutzer ist für mich niemals sichtbar, sodass es eine wirklich private und sichere Art ist, mit vertraulichen Aufnahmen umzugehen: denken Sie an Kommunen, vertrauliche Sitzungen und die Aufnahme von Kunden für wortgetreue Protokolle.
Was es kann
Transkription in Echtzeit
Sprechen Sie und sehen Sie den Text innerhalb einer Sekunde erscheinen, ohne auf Uploads oder Stapelverarbeitung zu warten.
Sprechererkennung
Automatische Sprecherkennzeichnungen (Speaker 1, Speaker 2, ...), damit Protokolle und Interviews leicht nachzuvollziehen sind.
Eigene GPU inference
Die KI-Modelle laufen auf meiner eigenen Hardware, sodass keine Abhängigkeit von externen Transkriptions-APIs besteht und niemals Daten meine sovereign Infrastruktur verlassen.
Mehrsprachig
Transkribieren Sie in vielen Sprachen, mit einer übersichtlichen Sprachauswahl, damit das Modell genau weiß, was zu erwarten ist.
Audio & Video hochladen
Nicht nur live: Laden Sie bestehende Audio- oder Videodateien hoch und erhalten Sie ein vollständiges, nach Sprechern gekennzeichnetes Transkript zurück.
Neu transkribieren auf Abruf
Lassen Sie eine gespeicherte Aufnahme erneut durch die Pipeline laufen, zum Beispiel mit einer anderen Sprache oder einem verbesserten Modell, ohne etwas Neues aufzunehmen.
Der schwierigste Teil: mehrsprachig, ohne abzudriften
Die größte Herausforderung bestand darin, ein KI-Sprachmodell einzurichten, das mehrere Sprachen gut beherrscht.
Der Haken: Sobald man eine Sprache wählt, muss das Modell dabei bleiben. Eine naive Konfiguration würde abdriften, ein deutscher Satz mit einem einzigen englischen Wort könnte plötzlich die gesamte Transkription mitten in der Sitzung auf eine andere Sprache umstellen. Für Protokolle, die wortgetreu sein müssen, ist das inakzeptabel.
Wie ich es gelöst habe
Explizite Sprachfixierung
Die ausgewählte Sprache wird für die gesamte Sitzung festgelegt und dem Modell bei jedem Audio-Abschnitt übergeben, anstatt es die Sprache pro Fragment automatisch erkennen zu lassen.
Streaming-Inferenz auf der GPU
Audio wird in kleinen Abschnitten an meine eigene GPU gestreamt, sodass Ergebnisse nahezu sofort vorliegen und gleichzeitig konsistent mit der festgelegten Sprache bleiben.
Sprecherbewusste Nachbearbeitung
Transkripte werden zusammengefügt und pro Sprecher gekennzeichnet, sodass die Ausgabe in der festgelegten Sprache sauber und gut lesbar bleibt.
Das Ergebnis: Wählen Sie Deutsch, und es bleibt Deutsch, selbst bei einem gelegentlichen englischen Wort, sodass das Transkript dem entspricht, was wirklich gesagt wurde.
Das Ergebnis in Zahlen
<1s
Latenz von Sprache zu Text
99+
Unterstützte Sprachen
100%
Sovereign Cloud, kein Zugriff durch Dritte
Das Resultat
ScribeDash verwandelt eine mühsame Aufgabe, das Verfassen wortgetreuer Protokolle, in etwas, das live geschieht. Während einer Sitzung sehen Sie bereits, wie das Transkript entsteht, und danach können Sie das Audio neben dem exakten Text abspielen.
Da alles auf meiner eigenen sovereign, selbst verwalteten Infrastruktur läuft und niemand (nicht einmal ich) die Transkripte anderer Nutzer einsehen kann, bleibt es schnell, privat und sicher, selbst bei den sensibelsten Themen.
Live
Text erscheint, während Sie sprechen
Wortgetreu
Audio und Text nebeneinander
Privat
Läuft auf eigener GPU, keine externe API
Hinter den Kulissen
Möchten Sie so etwas haben?
Von Echtzeit-KI-Apps bis zu self-hosted Modellen auf Ihrer eigenen Hardware: Wenn Sie es sich ausdenken können, kann ich es bauen.