منتج SaaS مبني ذاتيًا · ذكاء اصطناعي في الوقت الفعلي
ScribeDash
تطبيق ويب لتحويل الكلام إلى نص في الوقت الفعلي يحوّل الصوت المباشر إلى نصوص دقيقة مصنّفة حسب المتحدث أثناء حديثك. صِل ميكروفونًا، اضغط تسجيل، وشاهد الكلمات تظهر على الفور، مدعومة بالذكاء الاصطناعي الذي يعمل على GPU inference الخاص بي.
نظرة داخل ScribeDash
من الصفحة الرئيسية إلى استوديو التسجيل المباشر.
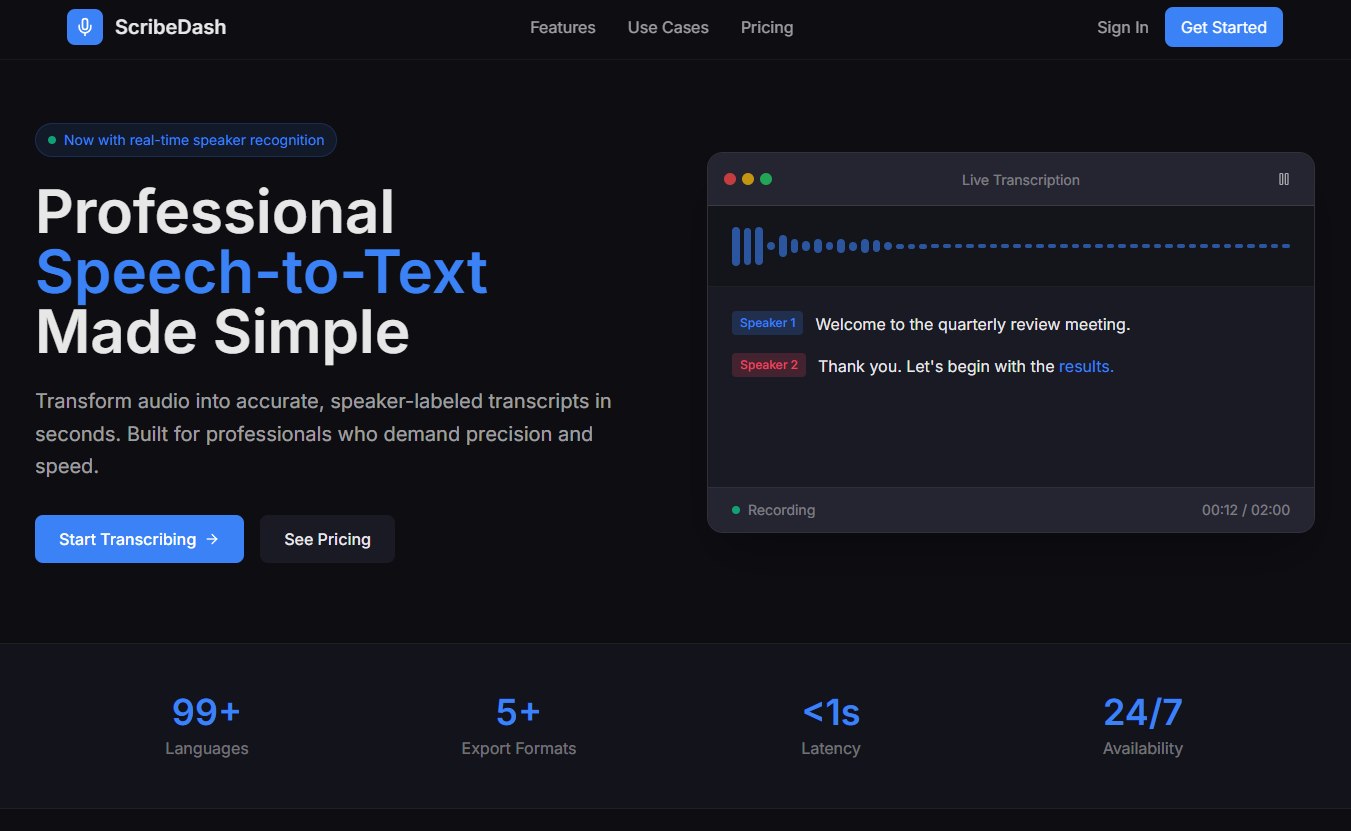
تحويل احترافي للكلام إلى نص
الصفحة الرئيسية: حوّل الصوت إلى نصوص دقيقة مصنّفة حسب المتحدث في ثوانٍ.
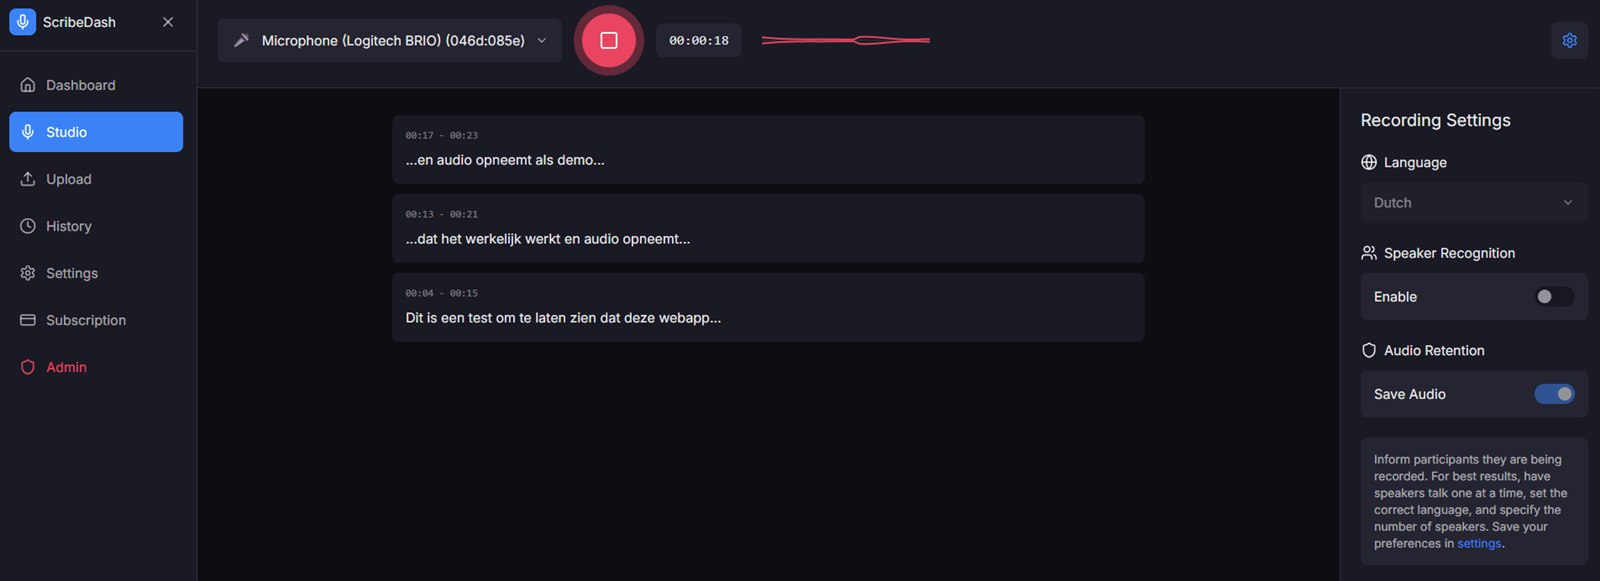
استوديو التسجيل المباشر
سجّل من أي ميكروفون وشاهد النص يتدفق في الوقت الفعلي، مع إعدادات اللغة والتعرّف على المتحدث.
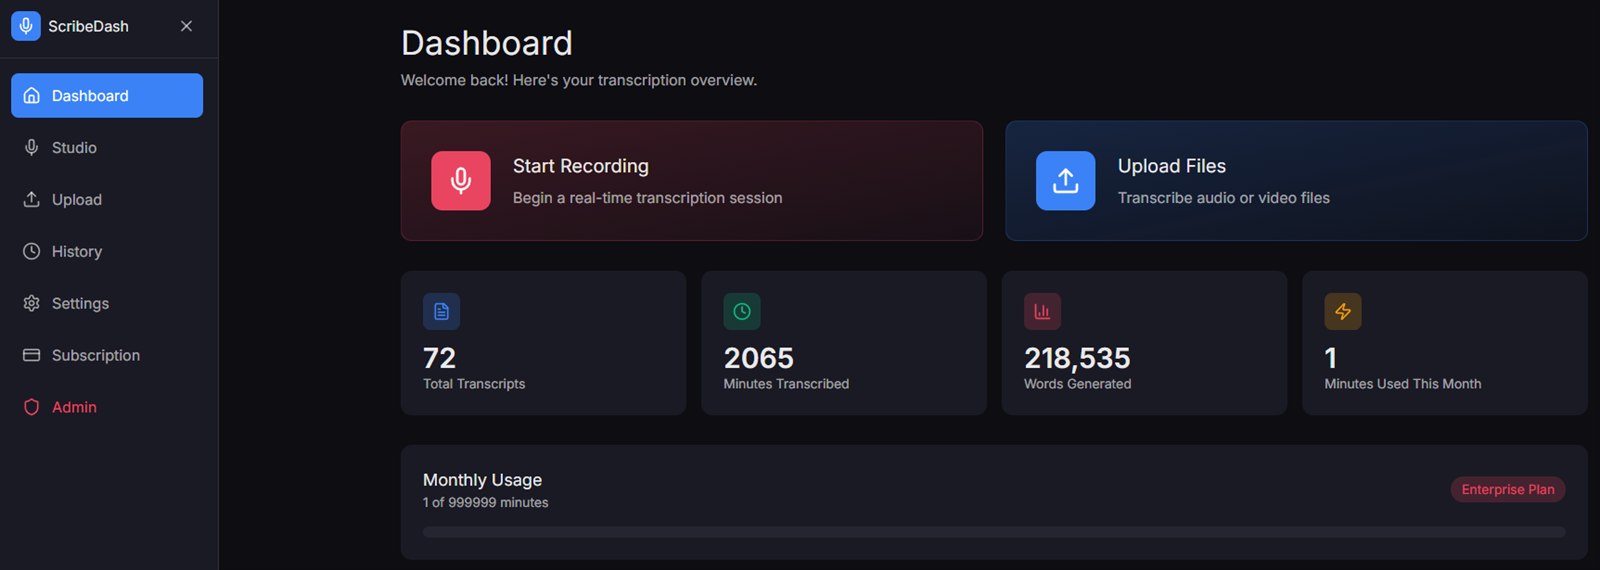
لوحة تحكم النسخ الخاصة بك
نظرة عامة على النصوص، والدقائق المنسوخة والكلمات المُنشأة، مع إجراءات سريعة للتسجيل أو الرفع.
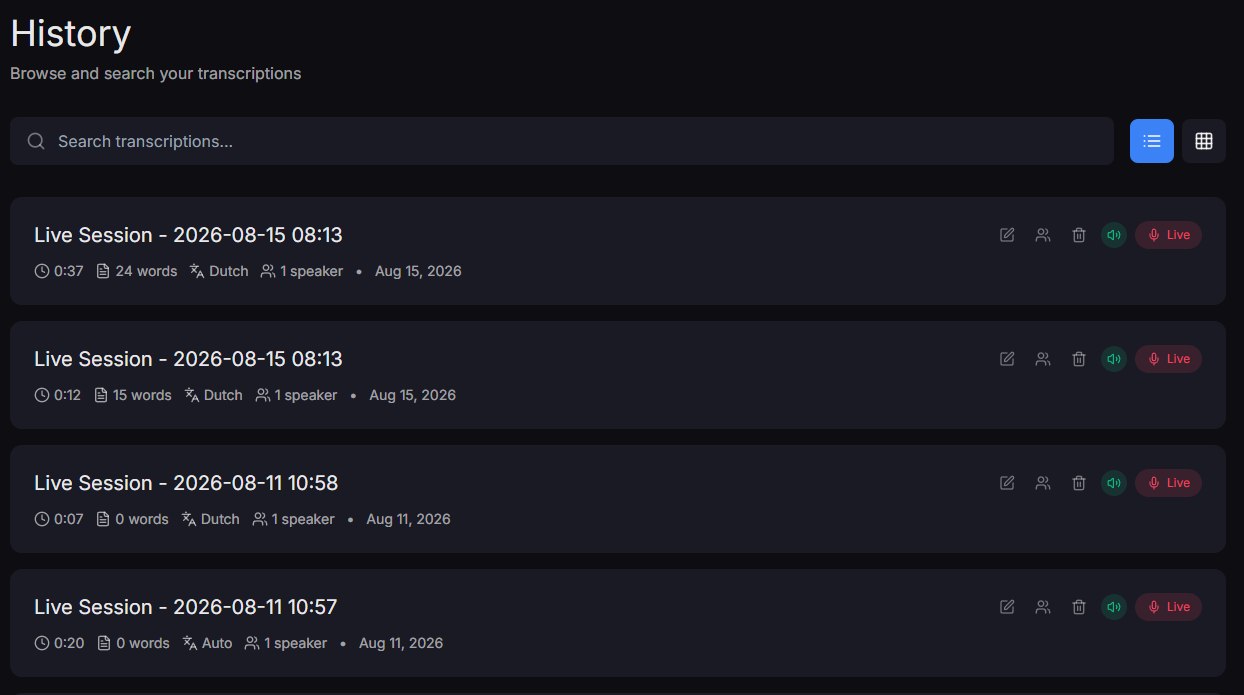
سجل قابل للبحث
كل جلسة محفوظة وقابلة للبحث ومصنّفة حسب اللغة والمدة والمتحدثين.
المشروع
ScribeDash
النوع
تطبيق ويب للنسخ في الوقت الفعلي
التقنية
React, WebSockets, GPU inference
السنة
2025
لماذا بنيتُ ScribeDash
بصفتي أمين سرّ لمجلس إدارة، كنت أكتب محاضر الاجتماعات بانتظام، لذا أعرف مدى قيمة أن يكون الصوت المُسجّل بجانب النص المنسوخ للتحقق، كلمةً بكلمة، مما قيل فعلًا. المشكلة: كانت خاصية النسخ المدمجة في Office 365 غير قابلة للاستخدام بصراحة، وأنهكني Copilot في Teams بسرعة دون أن يقدّم فائدة تُذكر، لذا قررت ببساطة أن أبني بديلي الخاص.
فبنيتُ ScribeDash: تطبيق ويب للنسخ في الوقت الفعلي عبر الإنترنت. صِل ميكروفونًا، ابدأ التسجيل، وستظهر كلماتك المنطوقة نصًا على الفور، مع تصنيفات المتحدثين لترى مَن قال ماذا. يمكنك أيضًا رفع ملفات صوتية أو مرئية موجودة، أو تمرير تسجيل محفوظ عبر السلسلة مجددًا لإعادة نسخه.
كل شيء يعمل على بنيتي التحتية السيادية (sovereign) الخاصة، التي أديرها من البداية إلى النهاية. النص المنسوخ للمستخدمين الآخرين غير مرئي لي أبدًا، لذا فهي طريقة خاصة وآمنة حقًا للتعامل مع التسجيلات الحساسة: فكّر في البلديات والاجتماعات السرية وتسجيل العملاء لمحاضر حرفية.
ماذا يفعل
نسخ في الوقت الفعلي
تحدّث وشاهد النص يظهر خلال ثانية، دون انتظار عمليات الرفع أو المعالجة الدفعية.
التعرّف على المتحدث
تصنيفات تلقائية للمتحدثين (Speaker 1، Speaker 2، ...) لتسهيل متابعة المحاضر والمقابلات.
GPU inference خاص بي
تعمل نماذج الذكاء الاصطناعي على أجهزتي الخاصة، فلا اعتماد على واجهات API خارجية للنسخ ولا تغادر أي بيانات بنيتي التحتية السيادية (sovereign) أبدًا.
متعدد اللغات
انسخ بلغات كثيرة، مع مُحدِّد لغة واضح ليعرف النموذج بالضبط ما يتوقعه.
رفع الصوت والفيديو
ليس المباشر فحسب: أفلِت ملفات صوتية أو مرئية موجودة واحصل على نص كامل مصنّف حسب المتحدث.
إعادة النسخ عند الطلب
مرّر تسجيلًا محفوظًا عبر السلسلة مجددًا، مثلًا بلغة مختلفة أو بنموذج مُحسَّن، دون تسجيل أي شيء جديد.
أصعب جزء: تعدد اللغات دون انحراف
كان التحدي الأصعب هو ربط نموذج لغوي بالذكاء الاصطناعي يتعامل مع لغات متعددة بشكل جيد.
المشكلة: بمجرد اختيارك لغةً، على النموذج أن يلتزم بها. أي إعداد ساذج سينحرف، فجملة هولندية بها كلمة إنجليزية واحدة قد تقلب النسخ بأكمله فجأة إلى لغة أخرى في منتصف الجلسة. وبالنسبة للمحاضر التي يجب أن تكون حرفية، فهذا غير مقبول.
كيف حللتُ ذلك
قفل صريح للغة
تُثبَّت اللغة المختارة طوال الجلسة وتُمرَّر إلى النموذج مع كل مقطع صوتي، بدلًا من تركه يكتشفها تلقائيًا لكل جزء.
استدلال متدفق على GPU
يُبثّ الصوت إلى GPU الخاص بي في مقاطع صغيرة، فتكون النتائج شبه فورية مع بقائها متسقة مع اللغة المقفلة.
معالجة لاحقة واعية بالمتحدث
تُجمَّع النصوص معًا وتُصنَّف حسب كل متحدث، فيبقى ناتج اللغة المقفلة نظيفًا وسهل القراءة.
النتيجة: اختر الهولندية فتبقى هولندية، حتى مع ورود كلمة إنجليزية بين الحين والآخر، فيطابق النص ما قيل فعلًا.
النتيجة بالأرقام
<1s
زمن الاستجابة من الكلام إلى النص
99+
اللغات المدعومة
100%
سحابة سيادية، دون وصول طرف ثالث
الحصيلة
يحوّل ScribeDash مهمة مملة، وهي كتابة محاضر حرفية، إلى شيء يحدث مباشرةً. أثناء الاجتماع ترى النص وهو يُبنى بالفعل، وبعده يمكنك إعادة تشغيل الصوت بجانب النص الدقيق.
ولأن كل شيء يعمل على بنيتي التحتية السيادية (sovereign) المُدارة ذاتيًا، ولا أحد (ولا حتى أنا) يمكنه رؤية نصوص المستخدمين الآخرين، فإنه يبقى سريعًا وخاصًا وآمنًا، حتى لأكثر المواضيع حساسية.
مباشر
يظهر النص أثناء حديثك
حرفي
الصوت والنص جنبًا إلى جنب
خاص
يعمل على GPU خاص، دون API خارجي
خلف الكواليس
تريد شيئًا كهذا؟
من تطبيقات الذكاء الاصطناعي في الوقت الفعلي إلى النماذج المستضافة ذاتيًا (self-hosted) على أجهزتك الخاصة: إن كنت تستطيع تخيّله، أستطيع بناءه.